Windows ML e llama.cpp: modelli GGUF, memoria e sandbox MXC
Microsoft introduce il supporto sperimentale a llama.cpp in Windows ML per modelli GGUF e rende disponibile Microsoft Execution Containers (MXC) per l'isolamento degli agenti AI tramite policy di sicurezza.
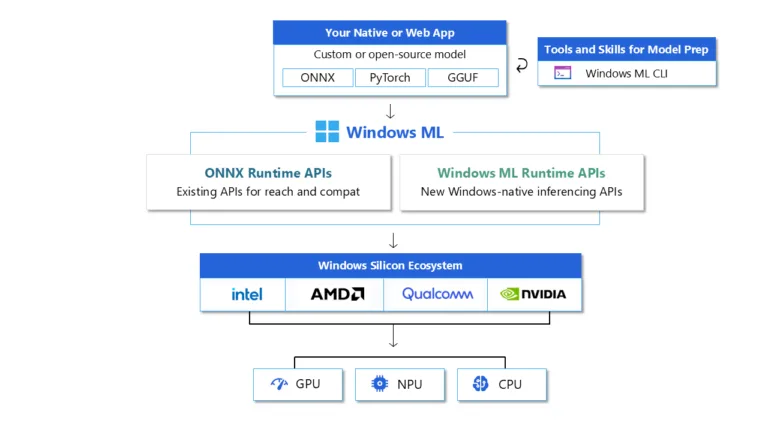
Il diagramma Microsoft affianca il percorso ONNX Runtime alle nuove API Windows ML. Il nuovo percorso nativo e l’integrazione GGUF sono sperimentali.Microsoft · immagine ufficialeFonte dell’immagine
Integrazione di llama.cpp in Windows ML
Il 7 ottobre 2026, Microsoft ha annunciato l'integrazione sperimentale di llama.cpp all'interno di Windows ML, il framework di inferenza locale per l'ecosistema Windows. Questa novità permette agli sviluppatori di eseguire modelli in formato GGUF direttamente sul dispositivo attraverso nuove API specifiche per task, a partire dalla Text Generation API, che accetta sia formati GGUF che ONNX tramite un'interfaccia semplificata. [1][4]
L'architettura di Windows ML è progettata per essere agnostica rispetto all'hardware, supportando GPU, NPU e CPU di produttori come AMD, Intel, NVIDIA e Qualcomm. Per facilitare la prototipazione, le nuove API espongono un endpoint compatibile con OpenAI, consentendo di utilizzare l'SDK di OpenAI per interagire con modelli locali senza dover apprendere nuovi protocolli, sebbene l'endpoint sia locale e non coincida con l'API cloud di OpenAI. [1]
È fondamentale chiarire che l'integrazione di llama.cpp è attualmente in fase sperimentale. Sebbene Windows ML automatizzi la selezione del motore di esecuzione, non vi è alcuna garanzia che ogni modello GGUF sia compatibile con tutte le NPU disponibili sul mercato; l'efficacia dell'inferenza dipenderà strettamente dall'ottimizzazione del modello specifico per l'hardware di destinazione. [1]
Cosa si può usare e cosa è ancora in distribuzione
Calendario tratto dagli annunci Microsoft. Una preview utilizzabile oggi non equivale a disponibilità generale.
L’annuncio di MXC non rende stabili tutti i backend. Entra, Agent 365 e le nuove policy Intune sono indicati come in arrivo nel documento tecnico.
Runtime API e ottimizzazione dei dati
Parallelamente al supporto GGUF, Microsoft ha rilasciato in versione preview la Windows-native Runtime API. A differenza delle API di alto livello, questa interfaccia offre un controllo più granulare, permettendo l'uso di tipi di dati nativi di Windows e percorsi zero-copy per l'invio di frame video, audio e immagini. Questo approccio riduce la necessità di scrivere manualmente conversioni di formato e pre-processamenti onerosi, sebbene non elimini completamente ogni fase di preparazione dei dati. [1]
La Runtime API consente inoltre di comporre pipeline multi-modello deterministiche, definendo esplicitamente il posizionamento di ogni stadio tra CPU, GPU e NPU. I modelli possono essere compilati preventivamente in artefatti pronti all'uso per accelerare l'avvio. Tuttavia, è importante notare che la compilazione anticipata serve a ottimizzare le prestazioni e la coerenza dell'esecuzione, ma non sostituisce le policy di sicurezza che devono essere gestite a livello di sistema o tramite MXC. [1]
L'introduzione di questo percorso nativo non sostituisce le API di ONNX Runtime, che rimangono pienamente supportate per garantire la compatibilità. Gli sviluppatori possono quindi adottare un approccio ibrido, mantenendo i flussi di lavoro ONNX esistenti e migrando verso la Runtime API solo quando è necessario un controllo più preciso sulle risorse hardware o un'integrazione più profonda con l'OS. [1]
Infografica · La novità, in tre punti. Fonti: [1][4][2]Leggi il contenuto dello schema
Sintesi dei fatti documentati nell’articolo. I riferimenti sono riportati sotto lo schema.
Punto 1 · Integrazione di llama.cpp in Windows ML: Il 7 ottobre 2026, Microsoft ha annunciato l'integrazione sperimentale di llama.cpp all'interno di Windows ML, il framework di inferenza locale per l'ecosistema Windows.
Punto 2 · Runtime API e ottimizzazione dei dati: Parallelamente al supporto GGUF, Microsoft ha rilasciato in versione preview la Windows-native Runtime API.
Punto 3 · Gestione della memoria e modelli MoE: Per quanto riguarda le prestazioni, i dati riportano un throughput di elaborazione del prompt (prompt processing) di 923,5 token al secondo per contesti di 64k e 769,8 per 128k.
Il diagramma Microsoft affianca il percorso ONNX Runtime alle nuove API Windows ML. Il nuovo percorso nativo e l’integrazione GGUF sono sperimentali. Fonte: Microsoft
Gestione della memoria e modelli MoE
Il formato del modello e la sua quantizzazione sono soltanto il primo pezzo del budget di memoria. MAI Code 1.1 Flash è un esempio significativo: Microsoft descrive un modello Mixture-of-Experts da 137 miliardi di parametri totali, con 6,8 miliardi attivi durante l’elaborazione. Quel secondo numero riguarda il calcolo e non significa che gli altri pesi spariscano dalla memoria. La versione quantizzata usata sul dispositivo occupa 53 GB, circa l’80% in meno rispetto alla variante Bfloat16: resta quindi un modello molto grande anche se a ogni token lavora soltanto una parte degli esperti. [2]
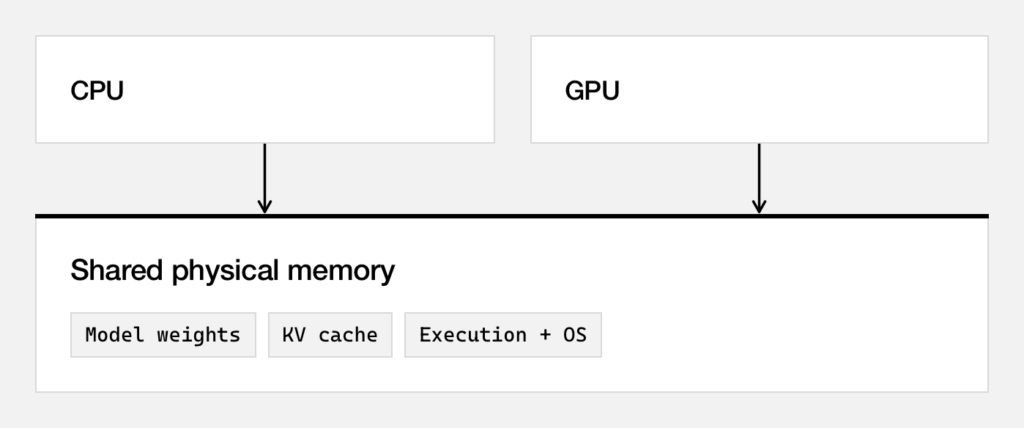
Microsoft riporta un picco di utilizzo di 75,5 GB sul Surface Laptop Ultra con un contesto di 256K token. Il valore descrive quella configurazione e quel carico, senza diventare un requisito generale di Windows ML. Il contesto richiede memoria aggiuntiva per la cache key-value, che conserva lo stato dell’attenzione dei token già elaborati; inoltre sistema operativo, applicazioni e runtime devono avere spazio disponibile. Per dimensionare una macchina occorre quindi distinguere il file dei pesi, la memoria di lavoro del modello e il margine necessario al resto del sistema. [2]
Per quanto riguarda le prestazioni, i dati riportano un throughput di elaborazione del prompt (prompt processing) di 923,5 token al secondo per contesti di 64k e 769,8 per 128k. È essenziale non confondere questi valori con la velocità di generazione (decode), che è tipicamente più lenta. Tali risultati sono stati ottenuti in un ambiente sintetico su ARM64 con runtime CUDA e DFlash2, e non sono quindi indicativi di prestazioni universali su ogni PC Windows. [2]
Lo schema Microsoft del budget di memoria: pesi, cache del contesto e sistema condividono le risorse. Il solo file del modello non rappresenta tutta la RAM necessaria. Fonte: Microsoft
Orchestrazione Hybrid Intelligence e Routing
Il percorso successivo è Hybrid Intelligence: GitHub HydraFusion dovrebbe scegliere quando conviene eseguire un compito sul dispositivo e quando usare modelli cloud. Gli annunci collocano la preview sperimentale locale nel corso di ottobre 2026 e indicano l’arrivo di queste capacità entro la fine del mese in Copilot app, CLI e VS Code. Questo calendario va tenuto distinto dal supporto sperimentale Windows ML annunciato il 7 ottobre e dalla disponibilità generale di MXC. Sono componenti collegati, con fasi di distribuzione differenti. [2][4]
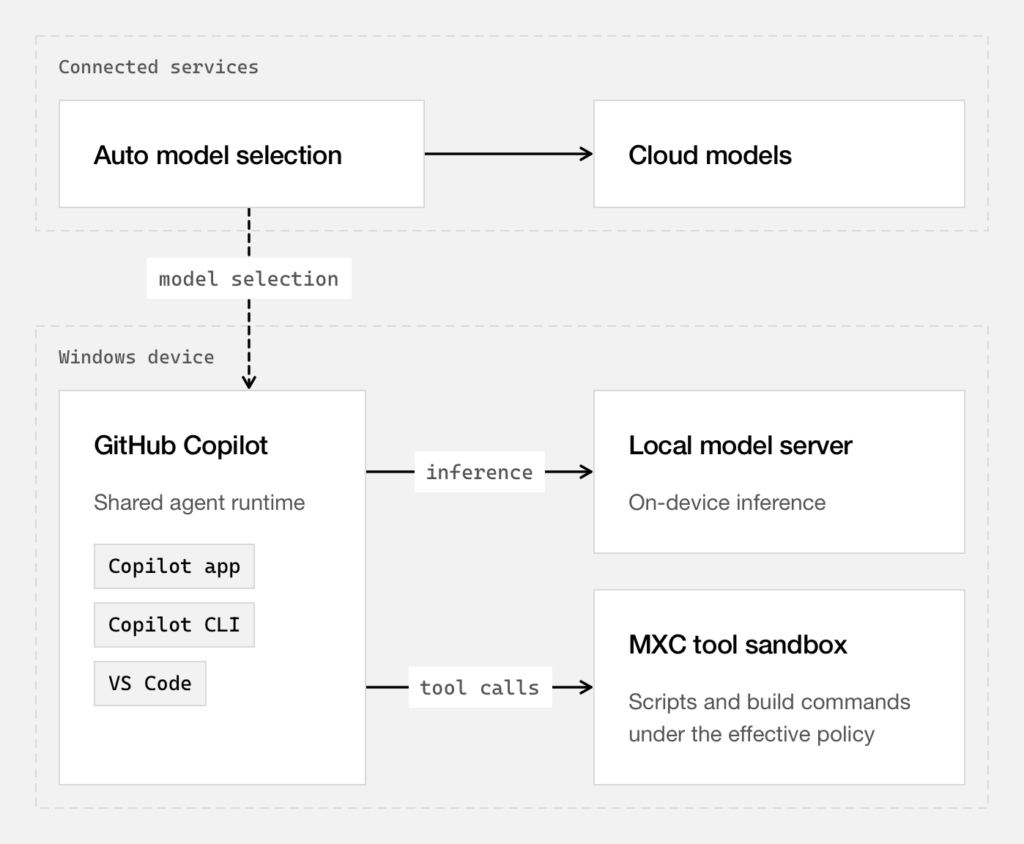
L'utente potrà scegliere tra l'orchestrazione automatica (Auto) e la selezione manuale di un modello locale o di un endpoint compatibile con OpenAI. È importante sottolineare che l'uso di modelli locali non rende la sessione completamente offline: l'orchestrazione di HydraFusion e altre funzionalità di Copilot richiedono comunque la connettività per il routing e la gestione della sessione. [2]
Chi vuole sperimentare oggi con le API Windows ML deve considerare i vincoli della loro versione sperimentale; questo non anticipa il rollout delle nuove scelte di modello in Copilot. Quando quelle opzioni saranno disponibili, il confronto utile sarà fra il controllo manuale e la selezione Auto, sulla base del lavoro da svolgere e delle risorse del dispositivo. Un’applicazione locale e una sessione di Copilot sono contesti diversi: dalla disponibilità di un runtime non si può dedurre che ogni integrazione descritta nell’annuncio sia già attivabile. [1][2]
Microsoft distingue scelta del modello, inferenza e strumenti. Un modello locale non implica che l’intera sessione funzioni senza rete. Fonte: Microsoft
Sicurezza e isolamento con MXC
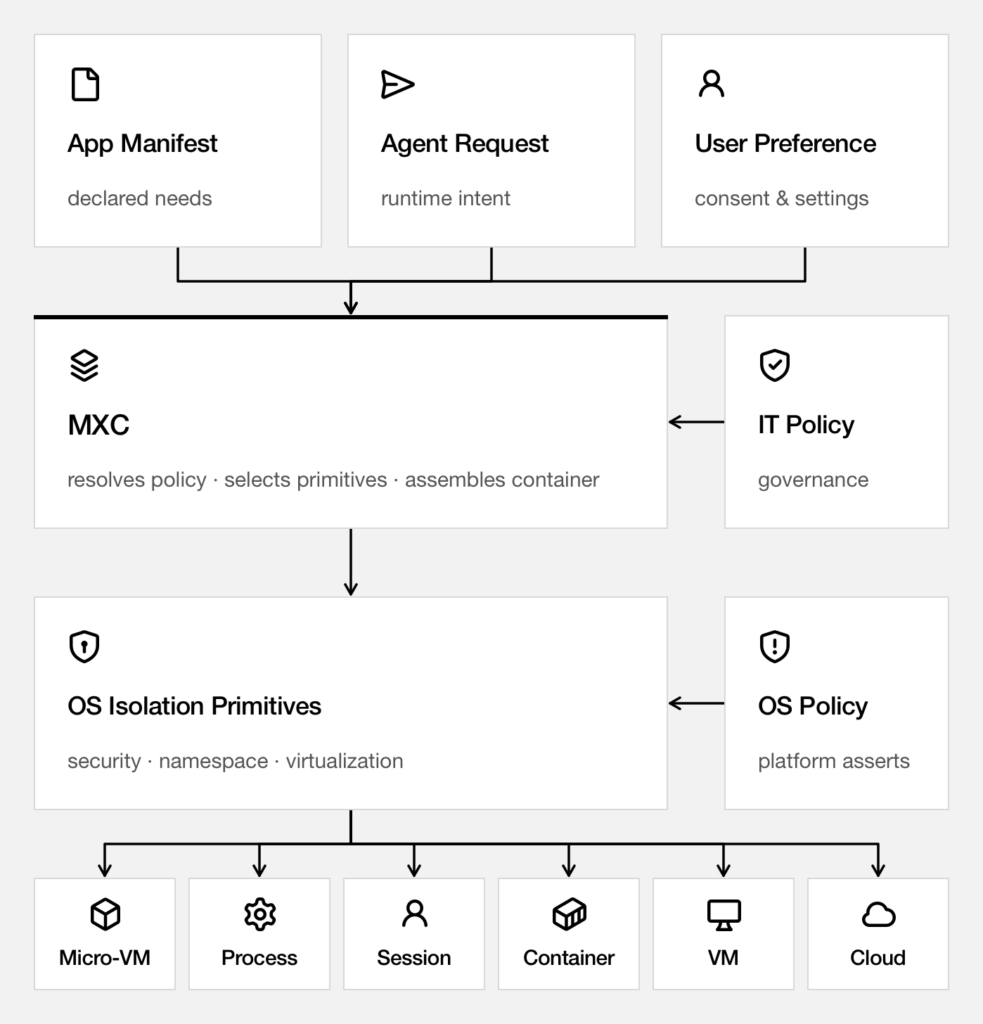
Per gestire i rischi legati all'esecuzione di codice generato da AI, Microsoft ha reso generalmente disponibile Microsoft Execution Containers (MXC). MXC è un layer di esecuzione basato su policy che isola gli agenti AI. Su Windows 11, utilizza AppContainer per i process container, mentre offre session container per isolare desktop e clipboard, e WSL container per toolchain Linux. Esiste inoltre un backend MicroVM, attualmente sperimentale su Windows 11 e Linux, per carichi ad alto rischio. [3][4]
Il sistema opera attraverso tre modalità di policy: Enforcement, che blocca l'accesso non autorizzato senza generare report; Learning, che blocca l'accesso e registra i tentativi in un report JSON per aiutare a definire i permessi; e Permissive, che consente l'operazione ma la registra. La modalità Permissive è utile per l'analisi, ma non fornisce una barriera di sicurezza effettiva, poiché non blocca le azioni dell'agente. [3]
Un aspetto critico riguarda i confini di isolamento: mentre i comandi shell e i server MCP locali girano all'interno del sandbox, i tool di file integrati in GitHub Copilot sono verificati dall'harness dell'agente e non tramite isolamento a livello di processo OS. Inoltre, i server MCP remoti si trovano al di fuori del sandbox locale e sono soggetti a policy di connessione separate. [2]
Il confine di esecuzione degli strumenti in Copilot: processi figli, strumenti interni e server MCP remoti hanno protezioni differenti. Fonte: Microsoft
Applicazione pratica e limiti di adozione
Un esempio illustrativo di implementazione prevede l'uso di un agente di coding che opera su una copia di lavoro di un repository. Per configurare l'ambiente, l'amministratore potrebbe avviare l'agente in modalità Learning per mappare esattamente quali file e tool di build sono necessari. Una volta analizzato il report JSON, si passa alla modalità Enforcement, limitando l'accesso solo a quelle cartelle e bloccando le connessioni di rete in uscita. [3]
È importante notare che il blocco della rete tramite MXC riduce i canali di esfiltrazione, ma non garantisce l'impossibilità assoluta di fuga dei dati se l'agente ha accesso a canali autorizzati. Inoltre, l'integrazione con Microsoft Entra e Intune per la gestione centralizzata delle policy MXC è indicata come imminente, ma non è ancora disponibile per tutti gli utenti, rendendo la gestione attuale manuale o basata su configurazioni locali. [3]
Il modello Microsoft da 53 GB è destinato a configurazioni con molta memoria, ma non stabilisce la quantità di RAM necessaria per qualsiasi utilizzo delle nuove API. Su una macchina più piccola, la prima verifica è la compatibilità fra modello, motore e hardware; poi vanno misurati memoria occupata, elaborazione del prompt e generazione durante un compito concreto. Ridurre la dimensione dei pesi o il contesto cambia il compromesso e richiede una verifica della qualità delle risposte. L’obiettivo pratico è scegliere una configurazione adatta al proprio lavoro, senza ricavare una promessa universale dal benchmark di un solo modello. [1][2]
Dalla lettura all'azione
Da mettere in pratica
Verificare la disponibilità di memoria unificata (RAM/VRAM) prima di caricare modelli MoE come MAI Code.
Utilizzare la modalità Learning di MXC per generare un report JSON delle risorse effettivamente richieste dall'agente.
Configurare l'endpoint locale compatibile con OpenAI per testare modelli GGUF tramite Windows ML.
Distinguere tra throughput di prompt processing e velocità di decode nei benchmark di performance.
Monitorare il rilascio di HydraFusion a fine ottobre per l'automazione del routing locale/cloud.
Valutare l'uso di Session Container su Windows 11 per isolare completamente l'agente dall'utente interattivo.
Il design introdotto con Firefox 157 cambia barre, temi e sidebar. Ecco le differenze pratiche, le correzioni video e i limiti da conoscere prima di cambiare impostazioni.
Analisi tecnica di Ubuntu 26.10 "Stonking Stingray", focalizzata sulla riduzione della superficie di attacco, l'adozione totale di Rust per le core utilities e le nuove misure di crittografia TPM.
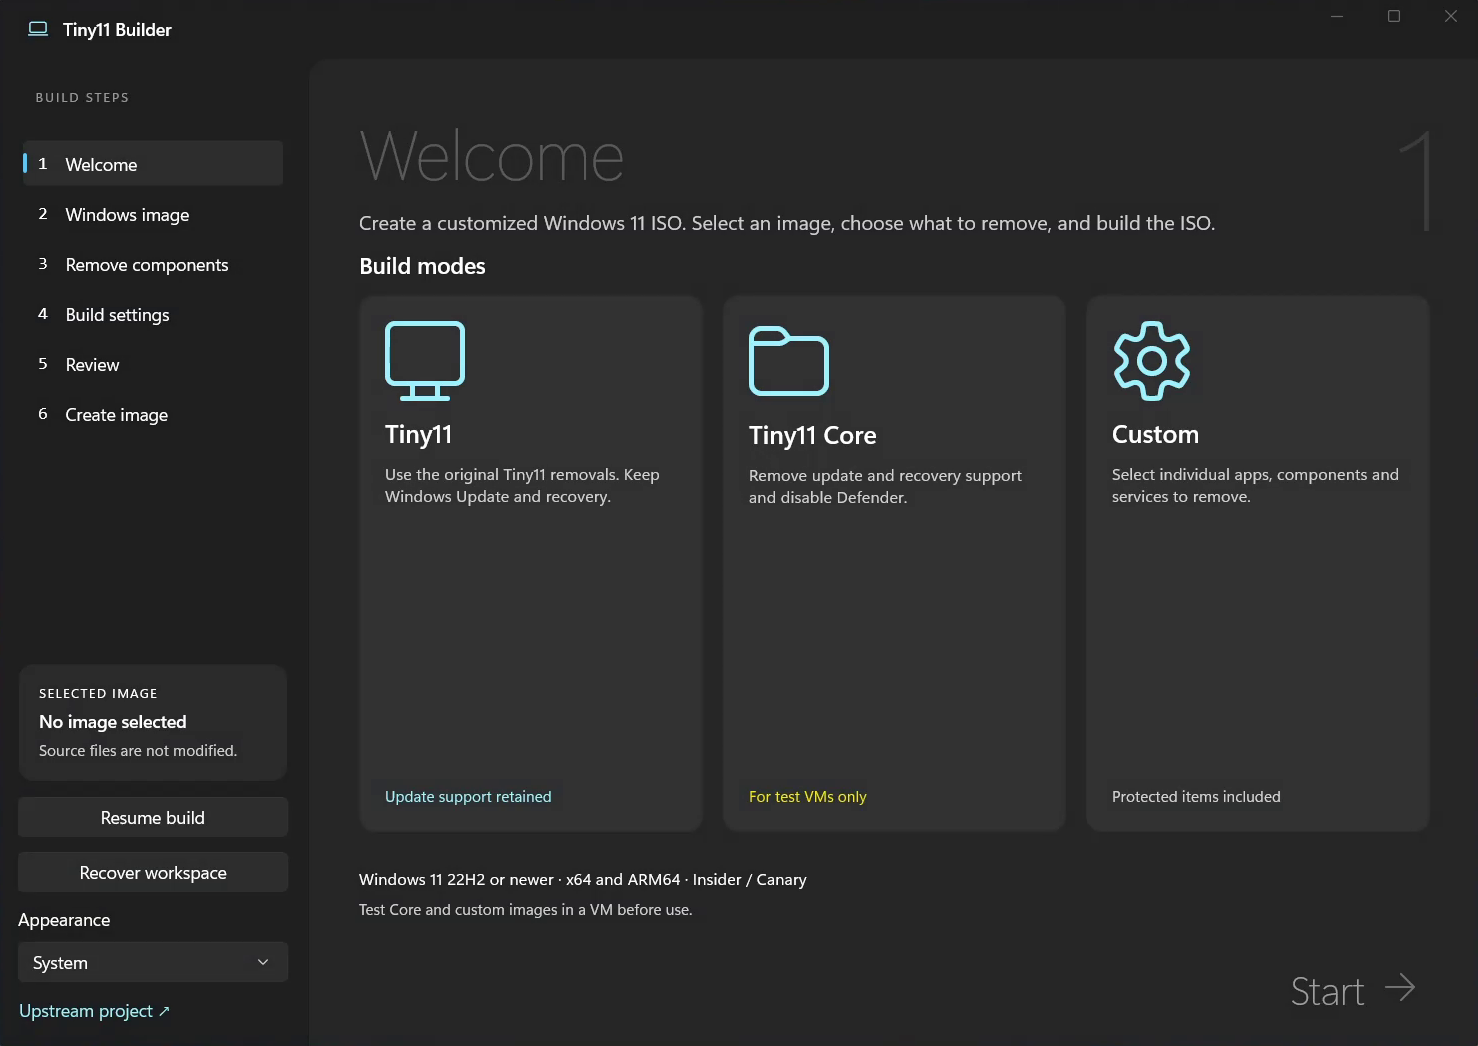
Rilasciata il 12 ottobre 2026, la versione v0.1.0-preview.1 di Tiny11 Builder evolve in un'app WinUI in C# per creare ISO di Windows 11 ridotte, introducendo modalità di rimozione differenziate e ottimizzazioni Turbo.


Parliamone
Hai un’esperienza da condividere o una domanda? Scrivi un commento pertinente, senza pubblicità o link.