Cloudflare Workers: analisi di CPU e memoria con il nuovo profiling on-demand
Cloudflare ha introdotto il 9 ottobre 2026 il profiling on-demand per Workers e Durable Objects, permettendo di identificare funzioni costose e allocazioni di memoria in produzione tramite flamegraph.
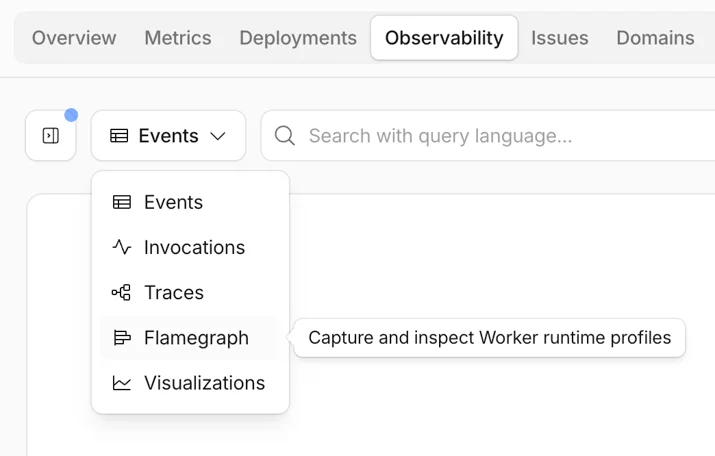
Schermata ufficiale Cloudflare del profiling in produzione: l’esempio illustra gli strumenti, non misure del nostro sito.Cloudflare · immagine ufficialeFonte dell’immagine
Il problema delle risorse in produzione
Identificare l'origine di un consumo eccessivo di CPU o di memoria in un'applicazione serverless è spesso complesso, poiché i log tradizionali e le metriche aggregate non forniscono il dettaglio necessario per individuare la funzione specifica responsabile del carico. Per risolvere questo limite, Cloudflare ha annunciato il 9 ottobre 2026 il supporto per il profiling on-demand di Workers e Durable Objects, consentendo agli sviluppatori di analizzare l'esecuzione reale in produzione invece di affidarsi solo a test locali. [1]
Questa novità è fondamentale perché il comportamento di un Worker in produzione differisce significativamente da quello in locale, sia per il volume che per la tipologia di richieste ricevute. Il nuovo strumento permette di richiedere un profilo CPU o di memoria di un Worker attivo, visualizzarlo come flamegraph interattivo e scaricare il file per analisi approfondite, offrendo una prospettiva concreta su come ottimizzare il codice in un contesto reale senza dover simulare carichi di lavoro artificiali. [1]
Schermata ufficiale Cloudflare del profiling in produzione: l’esempio illustra gli strumenti, non misure del nostro sito. Fonte: Cloudflare
CPU Time vs Heap Allocation
Il sistema distingue tra due tipologie di analisi: il profilo CPU e il profilo Heap. Il primo serve a identificare le funzioni che consumano più tempo di elaborazione, mentre il secondo si focalizza sulle allocazioni di memoria. Nello specifico, il profilo Heap non misura la memoria trattenuta (retained memory) né è un heap snapshot, ma registra una stack trace ogni 512 kB di memoria allocata durante la finestra di cattura, permettendo di risalire alla catena di chiamate responsabile di ogni allocazione campionata. [2]
È importante notare che il profiling CPU si concentra sul tempo di calcolo effettivo e non sul wall-time o sui tempi di attesa della rete. Per rendere questi dati leggibili, è essenziale abilitare le source maps nella configurazione di Wrangler impostando upload_source_maps su true, altrimenti il flamegraph mostrerà nomi di funzioni offuscati o minificati. Questo processo di traduzione è vitale poiché il codice JavaScript in produzione è tipicamente bundle-izzato e minificato per ottimizzare le prestazioni, rendendo i nomi originali inaccessibili senza i file di mappatura. [2][3]
Infografica · La novità, in tre punti. Fonti: [1][2]Leggi il contenuto dello schema
Sintesi dei fatti documentati nell’articolo. I riferimenti sono riportati sotto lo schema.
Punto 1 · Il problema delle risorse in produzione: Identificare l'origine di un consumo eccessivo di CPU o di memoria in un'applicazione serverless è spesso complesso, poiché i log tradizionali e le metriche aggregate non forniscono il dettaglio necessario per individuare la…
Punto 2 · CPU Time vs Heap Allocation: Il sistema distingue tra due tipologie di analisi: il profilo CPU e il profilo Heap.
Punto 3 · Operatività tramite CLI e API: Per eseguire il profiling senza passare dal dashboard, Cloudflare mette a disposizione la CLI cf e un'API dedicata.
Operatività tramite CLI e API
Per eseguire il profiling senza passare dal dashboard, Cloudflare mette a disposizione la CLI cf e un'API dedicata. Tramite CLI, è possibile catturare un profilo CPU per un Worker specifico utilizzando il comando: cf workers versions profile latest --profile-type cpu --duration-ms 5000 --worker-id "nome-del-worker" > profilo-cpu.pprof. Il comando richiede l'identificativo della versione (come 'latest' o un UUID) e la durata della sessione, che può variare da 1000 a 50000 millisecondi. [2]
L'integrazione via API avviene tramite una richiesta POST all'endpoint /profile, dove è possibile specificare nel corpo della richiesta la durata e il tipo di profilo (cpu o heap). Per i Durable Objects, l'API richiede inoltre i campi namespace_id e actor_id per colpire l'istanza specifica. I risultati vengono restituiti come file pprof compressi in gzip, compatibili con i tool di analisi standard del settore, permettendo l'integrazione in pipeline di monitoraggio esterne o l'uso di strumenti di analisi offline. [2]
Schermata ufficiale Cloudflare del profiling in produzione: l’esempio illustra gli strumenti, non misure del nostro sito. Fonte: Cloudflare
Esempio illustrativo: ottimizzazione JSON
Consideriamo un caso illustrativo in cui un Worker deve serializzare un oggetto JSON di grandi dimensioni prima di inviarlo al client. Se lo sviluppatore nota un rallentamento, potrebbe ipotizzare che il collo di bottiglia sia la latenza di rete (fetch lento), ma l'analisi tramite flamegraph potrebbe rivelare che il tempo è invece consumato da una funzione di trasformazione ricorsiva. Se una funzione di 'replacer' per JSON.stringify cammina l'albero dei dati mentre viene già chiamata ricorsivamente dal motore JSON, il lavoro viene duplicato. [1]
In questo scenario, l'analisi del profilo permetterebbe di individuare la funzione più larga nel flamegraph e, passando alla vista tabellare, verificare che tale funzione occupi una percentuale significativa della CPU. Una volta identificata la ridondanza, l'eliminazione del lavoro duplicato potrebbe portare a miglioramenti drastici delle prestazioni. Un caso reale documentato ha visto una funzione genericR2JsonReplacer diventare 2.7 volte più veloce dopo aver eliminato l'attraversamento ridondante dell'albero JSON, dimostrando come il profiling possa svelare inefficienze invisibili ai log. [1]
Per rendere utile questo esempio, conviene formulare una domanda verificabile prima di modificare il codice: il costo cresce soprattutto con il numero di elementi o con la profondità degli oggetti? Si possono preparare due richieste illustrative che differiscono in una sola di queste caratteristiche e confrontare poi i profili raccolti. Dopo una modifica, una finestra di osservazione scelta con lo stesso criterio aiuta a capire se il lavoro è davvero diminuito o se si è semplicemente spostato in un'altra funzione.
Gestione dei Durable Objects
A differenza dei Worker standard, che sono stateless e vengono campionati casualmente tra gli isolati attivi, i Durable Objects sono stateful e possiedono un'identità univoca. Questo permette al sistema di routing di Cloudflare di indirizzare la richiesta di profiling esattamente verso il metal (server fisico) che ospita l'attore primario specifico, fornendo un profilo dell'isolato che sta eseguendo quell'oggetto in quel preciso momento, indipendentemente dalla sua posizione geografica. [1][2]
Per profilare un Durable Object via CLI, è necessario passare i parametri --namespace-id e --actor-id. Questo livello di precisione è fondamentale per risolvere problemi di memoria specifici di un'istanza che gestisce uno stato pesante, evitando di diluire i dati su istanze diverse. Ad esempio, l'identificazione di codice Prometheus parzialmente disabilitato che causava errori di 'Exceeded Memory' (con P999 a 133 MB su un limite di 128 MB) è stata possibile solo grazie a un heap profile mirato che ha rivelato come tale codice occupasse il 66.7% delle allocazioni. [1][2]
Schermata ufficiale Cloudflare del profiling in produzione: l’esempio illustra gli strumenti, non misure del nostro sito. Fonte: Cloudflare
Limiti tecnici e requisiti di traffico
Il profiling on-demand non avvia un nuovo isolato, ma analizza quelli già caricati e attivi. Di conseguenza, se un Worker riceve pochissimo traffico, potrebbe essere difficile catturare un profilo utile poiché il sistema non trova un isolato attivo da campionare. In caso di assenza di esecuzioni recenti, l'API restituirà un errore specifico indicando che non sono stati trovati isolati caricati o che non vi sono state esecuzioni recenti per quel Worker. [1][2]
Un altro limite significativo riguarda la finestra temporale: il profiler cattura solo ciò che accade durante la durata selezionata, con un massimo di 50 secondi. Eventi rari o allocazioni che avvengono esclusivamente durante la fase di start-up non saranno visibili. Per superare questo limite, Cloudflare ha indicato di lavorare a un sistema di continuous profiling che automatizzi la cattura dei campioni, permettendo di esplorare i profili nel dashboard senza dover avviare manualmente la sessione nel momento esatto del malfunzionamento. [1][2]
Dalla lettura all'azione
Da mettere in pratica
Abilitare upload_source_maps in Wrangler per avere nomi di funzioni leggibili nel flamegraph
Assicurarsi che il Worker riceva traffico costante durante la finestra di cattura
Utilizzare la vista Table per identificare rapidamente le funzioni con il maggior 'Self' time
Verificare che la versione selezionata per il profiling sia effettivamente quella distribuita in produzione
Configurare correttamente namespace_id e actor_id quando si analizzano i Durable Objects
Il design introdotto con Firefox 157 cambia barre, temi e sidebar. Ecco le differenze pratiche, le correzioni video e i limiti da conoscere prima di cambiare impostazioni.
Analisi tecnica di Ubuntu 26.10 "Stonking Stingray", focalizzata sulla riduzione della superficie di attacco, l'adozione totale di Rust per le core utilities e le nuove misure di crittografia TPM.
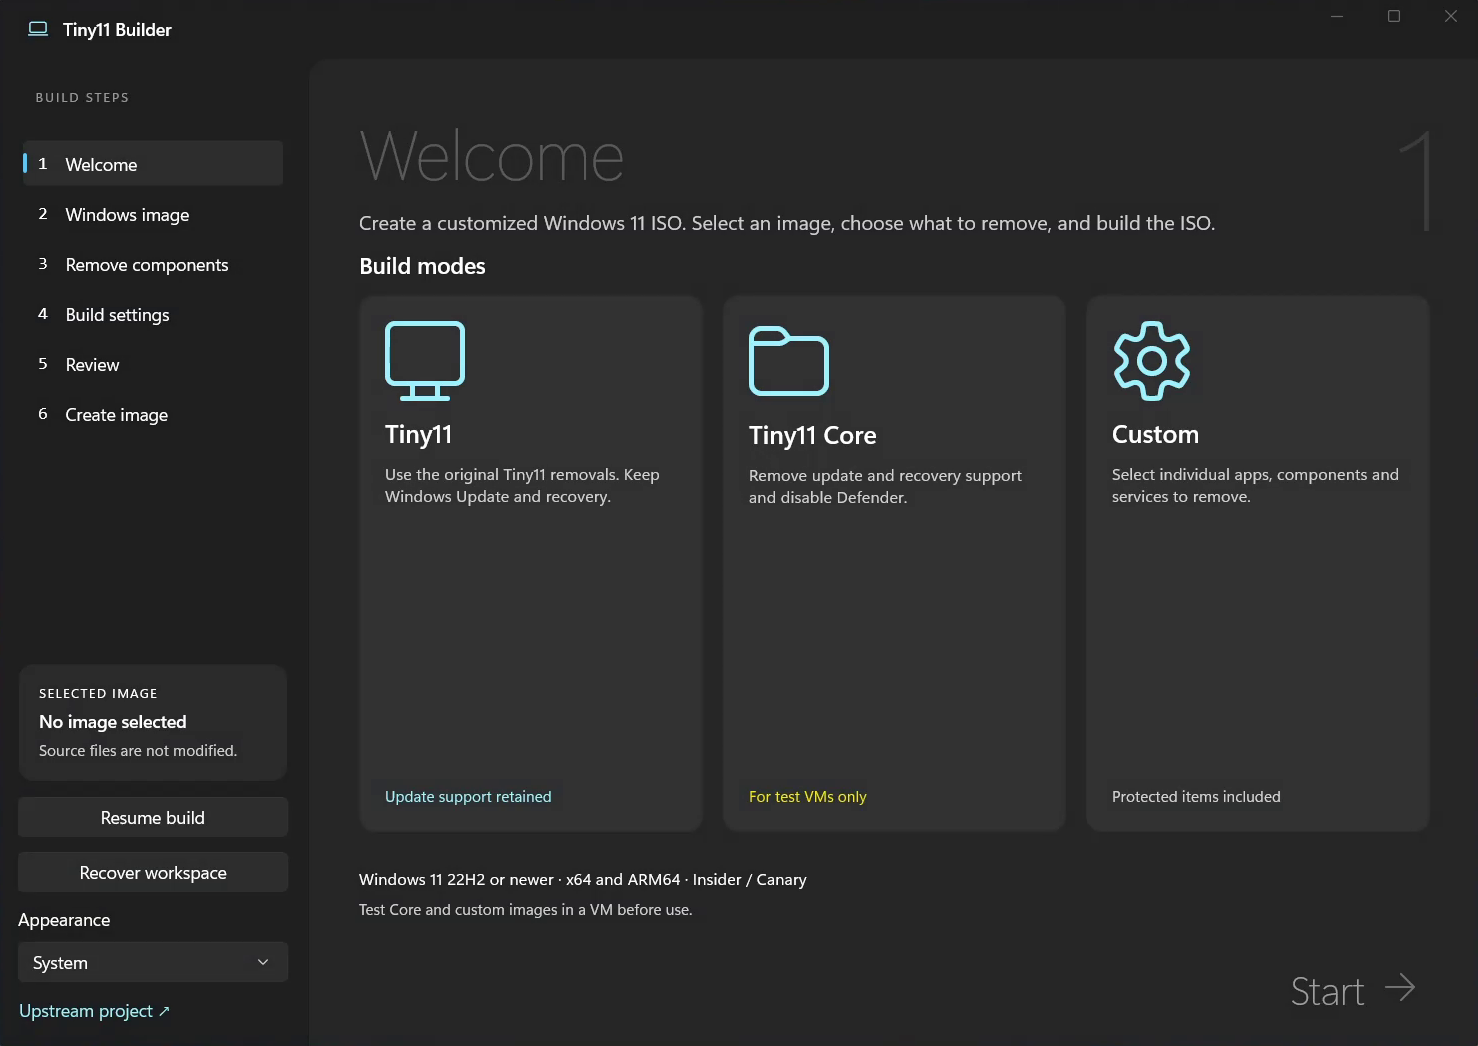
Rilasciata il 12 ottobre 2026, la versione v0.1.0-preview.1 di Tiny11 Builder evolve in un'app WinUI in C# per creare ISO di Windows 11 ridotte, introducendo modalità di rimozione differenziate e ottimizzazioni Turbo.


Parliamone
Hai un’esperienza da condividere o una domanda? Scrivi un commento pertinente, senza pubblicità o link.