OpenAI rilascia GPT-6.1 Sol: prestazioni elevate e costi ridotti per il coding professionale
Il 29 settembre OpenAI ha introdotto GPT-6.1 Sol, un modello ottimizzato per compiti complessi di programmazione e lavoro professionale, offrendo un'alternativa più economica rispetto a GPT-6 Astra.
Illustrazione editoriale di una postazione di sviluppo e revisione del codice.giuseppegambino.it · illustrazione originale
Cosa introduce GPT-6.1 Sol
Il 29 settembre OpenAI ha annunciato il rilascio di GPT-6.1 Sol, un nuovo modello progettato specificamente per affrontare carichi di lavoro professionali e attività di coding di alta complessità. La novità principale risiede nel posizionamento strategico del modello: esso mira a offrire prestazioni vicine a quelle di GPT-6 Astra, ma con una struttura di costi sensibilmente più contenuta. Questo lo rende uno strumento ideale per sviluppatori e aziende che necessitano di capacità di ragionamento avanzate senza dover sostenere le spese elevate tipiche dei modelli di punta della serie GPT-6. [1][3]
Oltre alla gestione del codice, il modello introduce il supporto in versione beta per il sistema Multi-agent. Questa funzionalità permette al modello principale di delegare compiti specifici a sub-agenti all'interno di una singola richiesta tramite la Responses API. In termini pratici, un utente potrebbe richiedere la creazione di un'intera architettura software e il modello potrebbe coordinare diversi agenti specializzati per scrivere il codice, testarlo e documentarlo, ottimizzando i flussi di lavoro che prima richiedevano un intervento manuale costante per ogni passaggio. [1]
Il nuovo modello di pricing
La struttura dei costi di GPT-6.1 Sol è pensata per favorire l'uso intensivo in contesti di sviluppo. Per prompt che non superano i 272.000 token di input, il prezzo standard è fissato a 2 dollari per 1 milione di token di input e 10 dollari per 1 milione di token di output. È presente anche una tariffazione agevolata per l'input in cache, pari a 0,10 dollari per milione di token, e un costo di 2,50 dollari per le operazioni di scrittura della cache. Questa differenziazione permette di ridurre drasticamente i costi durante sessioni di coding prolungate dove il contesto rimane costante. [1][3]
È importante notare che la gestione dei volumi elevati comporta variazioni tariffarie. Se un prompt supera la soglia dei 272.000 token di input, l'intero costo della richiesta viene ricalcolato con tariffe raddoppiate per l'input e la cache, e aumentate di 1,5 volte per l'output. Per le aziende che operano su larga scala, questo significa che la gestione efficiente della finestra di contesto non è solo una questione di prestazioni, ma un fattore critico per il controllo del budget operativo. Un'analisi attenta della dimensione dei prompt è quindi essenziale per evitare picchi di spesa imprevisti. [3]
Infografica · La novità, in tre punti. Fonti: [1][3][4]Leggi il contenuto dello schema
Sintesi dei fatti documentati nell’articolo. I riferimenti sono riportati sotto lo schema.
Punto 1 · Cosa introduce GPT-6.1 Sol: Il 29 settembre OpenAI ha annunciato il rilascio di GPT-6.1 Sol, un nuovo modello progettato specificamente per affrontare carichi di lavoro professionali e attività di coding di alta complessità.
Punto 2 · Il nuovo modello di pricing: La struttura dei costi di GPT-6.1 Sol è pensata per favorire l'uso intensivo in contesti di sviluppo.
Punto 3 · Come leggere i risultati dei benchmark: OpenAI riporta un vantaggio di 6,4 punti percentuali sul miglior risultato di GPT‑6 Sol in DeepSWE 1.1, ottenuto con uno sforzo inferiore.
Come leggere i risultati dei benchmark
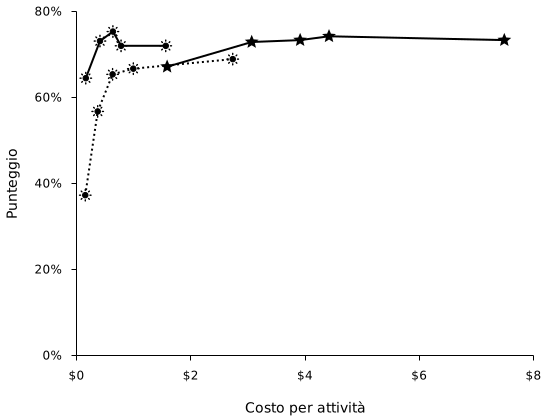
OpenAI riporta un vantaggio di 6,4 punti percentuali sul miglior risultato di GPT‑6 Sol in DeepSWE 1.1, ottenuto con uno sforzo inferiore. In AutomationBench il guadagno è di 4,8 punti a sforzo medio; in OSWorld 2.0 è di 7 punti a sforzo massimo. Sono confronti su prove diverse, non un unico indice di qualità. Il grafico conserva le condizioni di ciascuna misura; questi risultati del produttore non costituiscono test eseguiti dalla redazione. [4]
DeepSWE 1.1, grafico originale OpenAI. Giallo chiaro: GPT‑6.1 Sol; ocra: GPT‑6 Sol; blu: GPT‑6 Astra. I punti rappresentano diversi livelli di ragionamento. Valutazioni del produttore, non test svolti da questa redazione. Fonte: OpenAI
DATI / PRESTAZIONI
Il miglioramento rispetto a GPT‑6 Sol
Variazioni di punteggio nei singoli benchmark. Le impostazioni dei test differiscono: le barre non formano una classifica generale.
08 punti percentuali
DeepSWE 1.1 · coding
Sol 6.1 con sforzo inferiore supera il miglior punteggio di GPT‑6 Sol.
+6,4 p.p.
AutomationBench · flussi di lavoro
Entrambi i modelli con sforzo di ragionamento medio.
+4,8 p.p.
OSWorld 2.0 · uso del computer
Sforzo massimo; partial reward sul set offline, versione 2026.08.08.
+7 p.p.
Risultati dichiarati da OpenAI. Fonte [4]. Punti percentuali di differenza, non incrementi percentuali relativi. Le valutazioni del produttore possono differire dall’esperienza nei prodotti.
Integrazione con le Responses API
Un cambiamento tecnico fondamentale riguarda l'utilizzo delle funzioni esterne. Mentre i modelli precedenti potevano utilizzare il tool calling tramite la Chat Completions API, GPT-6.1 Sol richiede l'uso della Responses API per poter sfruttare gli strumenti nativi. La Responses API è un'interfaccia che gestisce le interazioni in modo più strutturato, permettendo al modello di interagire con strumenti come la ricerca web, l'interprete del codice o l'uso del computer. Questo passaggio obbliga gli sviluppatori a migrare parte del proprio codice per mantenere le funzionalità di automazione. [2][3]
Per chi sta migrando, la differenza principale risiede nel modo in cui vengono gestiti i dati in uscita. Nella Chat Completions API, il contenuto è solitamente letto tramite il campo message.content, mentre nella Responses API è necessario accedere a response.output_text. Inoltre, la gestione degli eventi in streaming cambia radicalmente: la Responses API utilizza eventi server-sent tipizzati, richiedendo che l'interfaccia utente o lo strato di orchestrazione sappia distinguere tra eventi come la creazione della risposta, i delta del testo o i risultati delle chiamate alle funzioni, evitando errori di parsing comuni durante la transizione. [2]
Capacità di ragionamento e strumenti
Il modello offre diverse opzioni per regolare lo sforzo di ragionamento (reasoning effort), permettendo di bilanciare velocità e profondità analitica. Le impostazioni disponibili includono low, medium (che rappresenta il valore predefinito), high, xhigh e max. È fondamentale sottolineare che le opzioni 'none' e 'minimal' non sono supportate per questo modello. Questa flessibilità consente di adattare il modello a compiti diversi: si può usare un livello basso per compiti di sintassi semplice o un livello massimo per la risoluzione di bug logici complessi in architetture distribuite. [3]
In termini di strumenti supportati, GPT-6.1 Sol è estremamente versatile quando utilizzato tramite la Responses API. Può integrare la ricerca web, l'interprete del codice, la generazione di immagini e persino il 'computer use', ovvero la capacità di interagire con un ambiente desktop. Per un team di sviluppo, questo significa poter costruire agenti che non solo scrivono codice, ma possono anche eseguire test in un ambiente isolato o cercare documentazione aggiornata sul web per risolvere problemi legati a librerie di ultima generazione, rendendo l'automazione molto più autonoma. [3]
Limiti e disponibilità geografica
Nonostante le capacità avanzate, esistono vincoli legati alla residenza dei dati e alle modalità di esecuzione. Il modello supporta la residenza dei dati sia negli Stati Uniti che nell'Unione Europea. Tuttavia, è importante notare che l'attivazione della 'Fast mode' non è disponibile per gli utenti che richiedono la residenza dei dati nell'UE. Questa limitazione è un aspetto critico per le organizzazioni europee che devono bilanciare la necessità di velocità di risposta con i rigorosi requisiti di conformità e protezione dei dati locali. [3]
Un altro limite da considerare riguarda le modalità di input e output. Sebbene il modello possa elaborare input testuali e immagini, non supporta l'input audio, né la generazione di video o l'input video. Per i professionisti che lavorano con contenuti multimediali, questo significa che GPT-6.1 Sol deve essere integrato in una pipeline più ampia che utilizzi altri modelli specializzati per la parte audio o video, limitando il suo ruolo principale a quello di motore di ragionamento logico, testuale e visivo (analisi immagini) all'interno di flussi di lavoro complessi. [3]
Esempio di implementazione tecnica
Per comprendere come implementare una chiamata che utilizzi strumenti nativi, consideriamo un caso d'uso in cui un assistente deve rispondere a una domanda sulla politica attuale utilizzando la ricerca web. Invece di scrivere una funzione personalizzata per la ricerca, lo sviluppatore può ora passare direttamente lo strumento tramite la Responses API. Questo approccio riduce la manutenzione del codice poiché l'integrazione con il motore di ricerca di OpenAI è gestita direttamente dal provider, garantendo una maggiore precisione nei risultati ottenuti. [2]
Tecnicamente, una richiesta strutturata per GPT-6.1 Sol con ricerca web integrata apparirebbe come un oggetto JSON inviato all'endpoint v1/responses, dove il campo 'tools' contiene un array con l'oggetto 'type: web_search'. Questo differisce radicalmente dal vecchio metodo 'functions' della Chat Completions API, dove era necessario definire manualmente lo schema dei parametri. Questa semplificazione permette di concentrarsi sulla logica applicativa piuttosto che sulla definizione dettagliata di ogni singola interazione con lo strumento esterno. [2]
Una prova di coding con criteri espliciti
Un esempio illustrativo: un gruppo di sviluppatori valuta un nuovo modello su una modifica già compresa dal team. Potrebbe fornire requisiti, vincoli e un criterio di completamento identici a quelli usati per il modello precedente, conservando tutti i tentativi. La valutazione considererebbe il risultato del lavoro, la necessità di correzioni e il tempo speso dai revisori, oltre alle condizioni economiche effettivamente documentate per il servizio scelto. [1]
Il team dovrebbe separare il completamento apparente dalla verifica del risultato: una risposta convincente può richiedere controlli ulteriori sul codice e sulle dipendenze. Un caso riuscito non dimostra un vantaggio per tutti i compiti. Per decidere se estendere la prova, si potrebbero confrontare attività diverse e annotare anche i fallimenti, evitando di selezionare soltanto gli esempi migliori. Quando una differenza di costo o prestazione non è misurata nel proprio contesto, dovrebbe restare un’ipotesi da verificare, distinta dalle dichiarazioni del produttore. [1]
Dalla lettura all'azione
Da mettere in pratica
Verificare se il workflow attuale richiede la Chat Completions API o se può migrare alla Responses API per usare i tool nativi.
Monitorare la dimensione dei prompt per restare sotto la soglia dei 272K token ed evitare il raddoppio dei costi.
Testare i livelli di 'reasoning effort' per trovare il miglior compromesso tra velocità e precisione nel coding.
Controllare la conformità sulla residenza dei dati se si opera in UE, considerando la limitazione della Fast mode.
Aggiornare i gestori di streaming per supportare i nuovi eventi tipizzati della Responses API.
Google sostituisce le Gems con le Skills, istruzioni riutilizzabili e combinabili. Analizziamo il meccanismo di stacking, l'integrazione in Workspace Studio e il cronoprogramma di migrazione per account personali e business.
Il 9 ottobre 2026 Cloudflare ha lanciato Clef-omni, un modello di decisione multimodale per audio e video. L'aggiornamento include nuovi prezzi per Clef-flash e ottimizzazioni di velocità per la famiglia Clef.

Parliamone
Hai un’esperienza da condividere o una domanda? Scrivi un commento pertinente, senza pubblicità o link.