NVIDIA apre i progetti dei rack Vera Rubin: l'impatto di MGX e DSX
NVIDIA condivide i progetti dei rack Vera Rubin tramite MGX e OCP. Ecco cosa cambia per alimentazione, raffreddamento, rete e gestione delle infrastrutture, e quali elementi restano futuri.
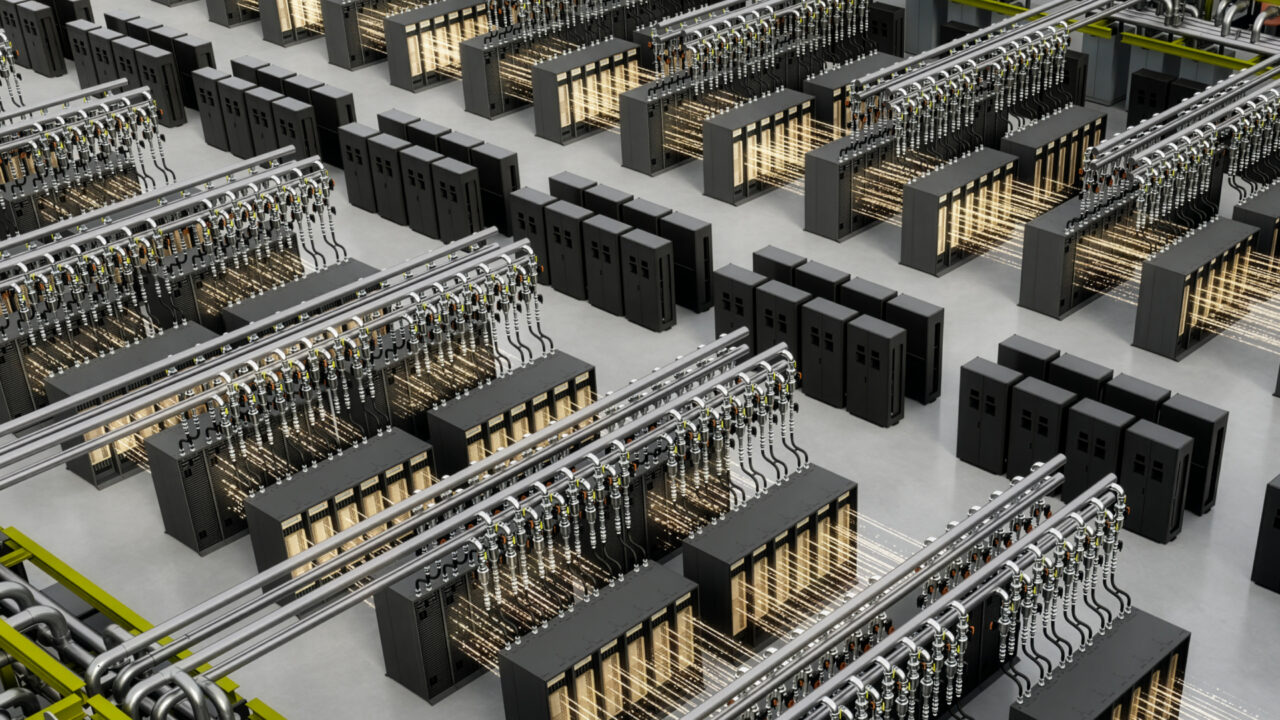
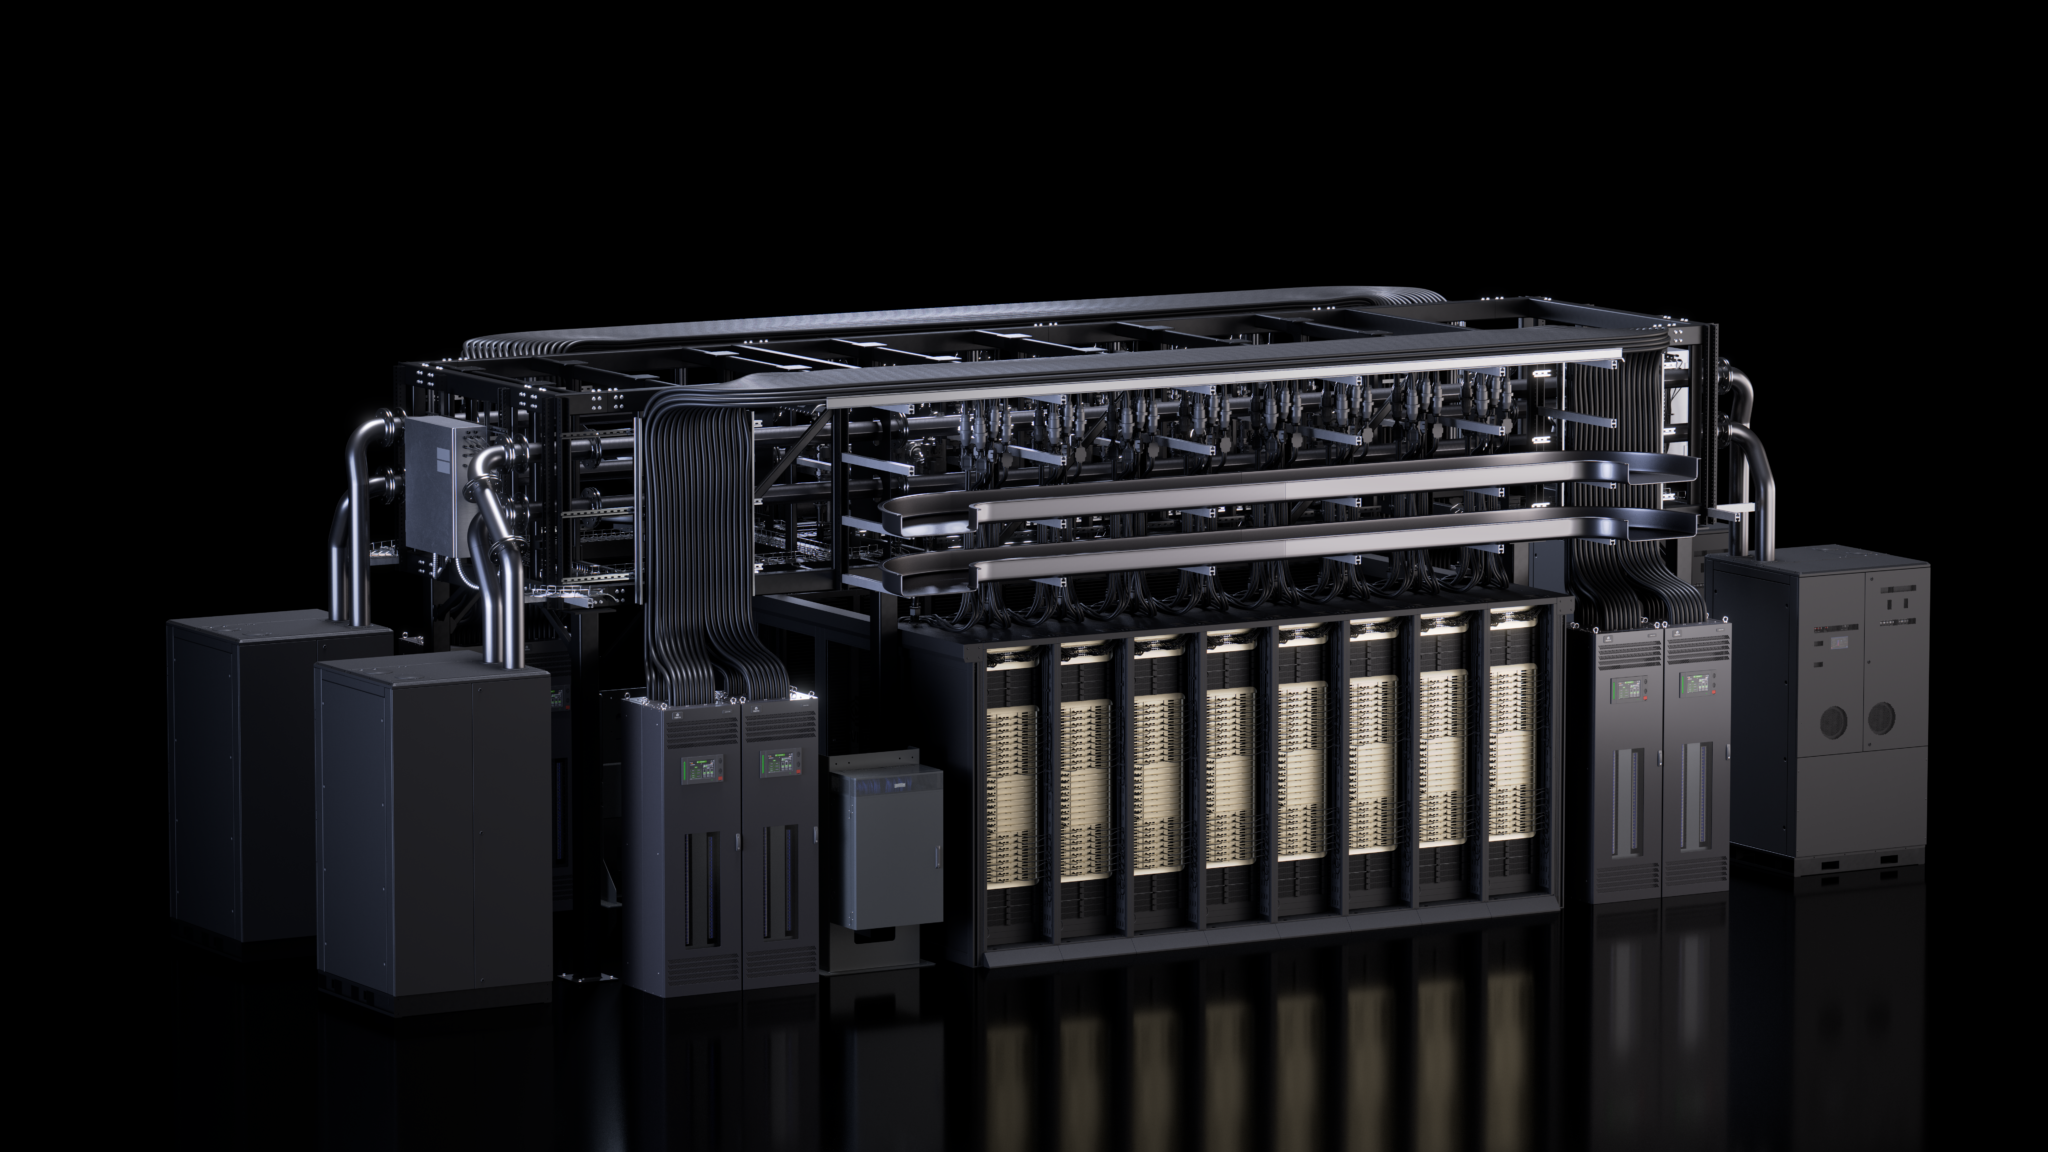
Vera Rubin e i rack nell’immagine ufficiale NVIDIA per OCP 2026.NVIDIA · immagine ufficialeFonte dell’immagine
L'apertura dei design Vera Rubin tramite OCP
Il 12 ottobre 2026, in occasione dell'Open Compute Project (OCP) Global Summit a San Jose, NVIDIA ha annunciato la condivisione dei progetti dei rack e dei compute tray per la piattaforma Vera Rubin. Questa iniziativa viene implementata attraverso l'architettura NVIDIA MGX, fornendo ai costruttori di sistemi una base comune per lo sviluppo dell'infrastruttura delle AI factory, che stanno evolvendo in termini di scala energetica passando da megawatt a gigawatt. [1]
L'obiettivo di questa strategia è accelerare la distribuzione di infrastrutture AI riducendo la dipendenza da specifiche proprietarie che spesso rallentano la fase di costruzione. Integrando i design di Vera Rubin nell'iniziativa Open DC di OCP, NVIDIA permette a produttori di hardware, provider di colocation e operatori di data center di progettare e fabbricare l'infrastruttura di supporto senza attendere specifiche individuali dai clienti finali. Questo approccio mira a migliorare l'efficienza energetica e le prestazioni espresse in token per watt, standardizzando l'interazione tra il sistema di calcolo e la rete elettrica. [1]
Vera Rubin e i rack nell’immagine ufficiale NVIDIA per OCP 2026. Fonte: NVIDIA
Specifiche tecniche di MGX 1.2 e limiti di potenza
La specifica MGX 1.2 introduce aggiornamenti strutturali per supportare la generazione Vera Rubin, tra cui l'estensione dell'architettura a rack-scale con raffreddamento a liquido blind-mate e un busbar a liquido da 5.000A, progettato per sistemi AI ad alta potenza. L'architettura è ora compatibile nativamente con l'attrezzatura da 19 pollici e supporta design di rack a densità più elevata, con una capacità di deployment che può raggiungere i 250kW per rack. Il sistema introduce inoltre compute tray senza ventole e interfacce di alimentazione e raffreddamento standardizzate per semplificare l'assemblaggio e la manutenzione. [1]
È necessario distinguere tra la capacità massima dell'architettura e il consumo effettivo: il valore di 250kW indica il limite superiore di supporto del rack e non implica che ogni singola configurazione consumi tale quantità di energia. L'adozione di tecnologie di raffreddamento a liquido open, come MQD e MQDB, permette di trasformare design già testati in standard industriali scalabili. Per un operatore, questo significa poter pianificare l'infrastruttura basandosi su un limite fisico noto, ottimizzando la distribuzione termica prima ancora di installare i componenti di calcolo effettivi. [1]
Infografica · La novità, in tre punti. Fonti: [1]Leggi il contenuto dello schema
Sintesi dei fatti documentati nell’articolo. I riferimenti sono riportati sotto lo schema.
Punto 1 · L'apertura dei design Vera Rubin tramite OCP: Il 12 ottobre 2026, in occasione dell'Open Compute Project (OCP) Global Summit a San Jose, NVIDIA ha annunciato la condivisione dei progetti dei rack e dei compute tray per la piattaforma Vera Rubin.
Punto 2 · Specifiche tecniche di MGX 1.2 e limiti di potenza: La specifica MGX 1.2 introduce aggiornamenti strutturali per supportare la generazione Vera Rubin, tra cui l'estensione dell'architettura a rack-scale con raffreddamento a liquido blind-mate e un busbar a liquido da 5.000A,…
Punto 3 · Vera CPU: l'infrastruttura per l'AI agentica: NVIDIA ha definito una netta separazione funzionale tra i sistemi di calcolo della piattaforma.
Vera CPU: l'infrastruttura per l'AI agentica
NVIDIA ha definito una netta separazione funzionale tra i sistemi di calcolo della piattaforma. Mentre il sistema Vera Rubin NVL72 funge da base per il training e l'inferenza su larga scala, il rack NVIDIA Vera CPU è progettato specificamente per l'era dell'AI agentica. Questo rack è ottimizzato per gestire l'orchestrazione, il tool calling e l'esecuzione in ambienti sandbox, permettendo agli agenti AI di interagire con applicazioni e servizi in tempo reale con risorse dedicate a questi compiti. [1]
A differenza dei sistemi consumer, il rack Vera CPU integra 256 processori NVIDIA Vera e supporta oltre 22.500 ambienti sandbox concorrenti. Questa architettura evita che i carichi di gestione, tipicamente caratterizzati da molte piccole operazioni di I/O e coordinamento, sottraggano cicli di calcolo alle GPU Rubin. Un esempio illustrativo riguarda un integratore che decide di separare i flussi: l'NVL72 gestisce la generazione del token (inferenza), mentre il rack Vera CPU gestisce la chiamata a un'API esterna o l'esecuzione di uno script in sandbox per verificare un dato, ottimizzando così l'uso dell'energia e riducendo la latenza complessiva del workflow agentico. [2]
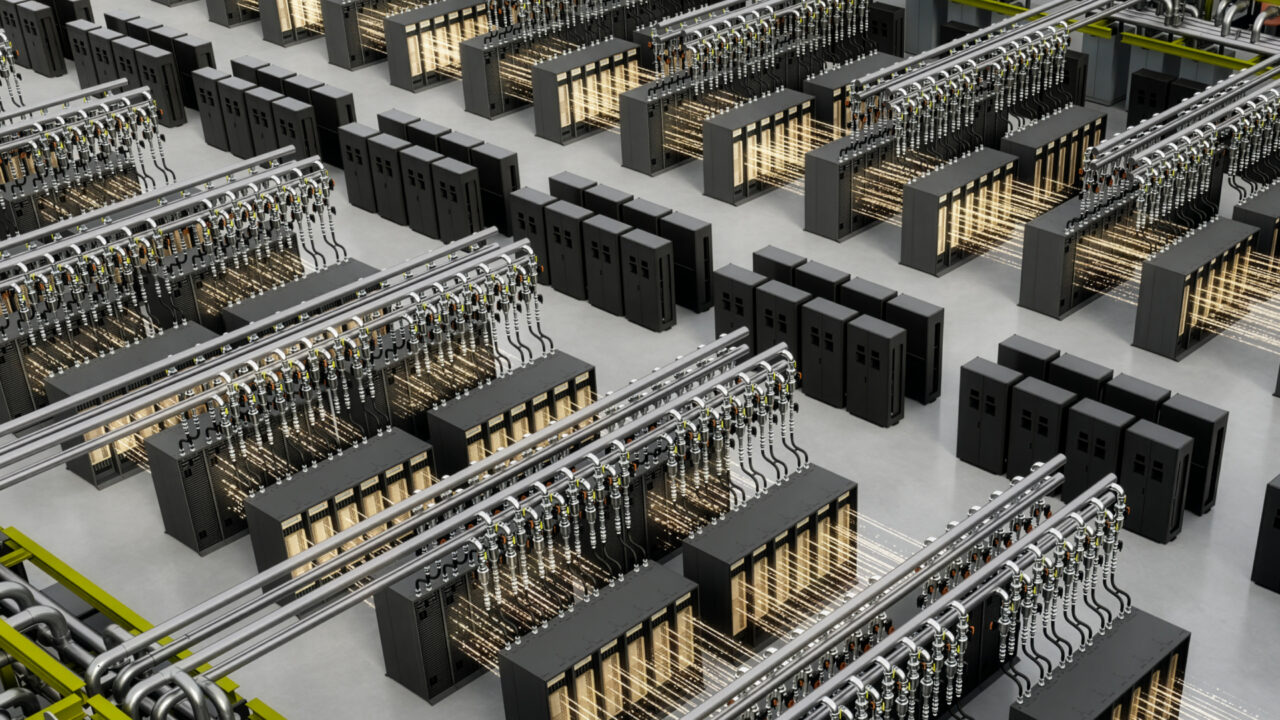
Architettura di alimentazione a 800 VDC nell’illustrazione ufficiale: un progetto di infrastruttura, non una misura di prestazioni. Fonte: NVIDIA
L'alimentazione a 800VDC e il progetto Visionbay K-1
Per risolvere il problema della densità energetica, dove la distribuzione a bassa tensione richiederebbe quantità eccessive di rame e cablaggi, è stato presentato il progetto K-1 di Visionbay. Questa piattaforma adotta un'architettura a 800V DC basata sui riferimenti NVIDIA e tecnologie termiche Vertiv, centralizzando la conversione AC-DC in centri di potenza a livello di cluster per distribuire l'energia più vicino ai compute tray. Questo approccio riduce la complessità del downstream power delivery e facilita l'espansione modulare delle AI factory. [1]
Visionbay presenta K-1 come una piattaforma per l'implementazione dell'architettura a 800VDC. L'annuncio non equivale alla disponibilità immediata di un prodotto standard in ogni mercato. Per chi gestisce un data center, il punto da valutare è l'integrazione fra conversione elettrica, distribuzione e raffreddamento: l'apertura dei riferimenti progettuali aiuta a confrontare le soluzioni, ma non dimostra che qualsiasi impianto esistente possa essere convertito senza lavori. Un progetto concreto richiede ancora una verifica delle caratteristiche del sito e dei componenti scelti. [1]
DSX OS: i nuovi componenti open source
NVIDIA ha ampliato DSX OS, il layer operativo che coordina l'architettura DSX AI Factory, rilasciando quattro componenti open source. Questi includono: NVIDIA Config Manager per l'automazione delle configurazioni degli switch; Cluster Readiness Engine per lo stress-test dei cluster GPU tramite simulazioni di carico reale; Rack Management Service per l'astrazione dell'hardware dei rack; e il Cluster API Provider per accelerare l'onboarding dei tenant su bare-metal, riducendo i tempi di deployment da giorni a ore. [1]
È fondamentale precisare che DSX OS non è un sistema operativo per desktop o server generici, ma un layer di orchestrazione per l'infrastruttura di fabbrica AI. Inoltre, l'utilizzo del Cluster Readiness Engine non deve essere interpretato come una certificazione di salute dell'hardware a vita, ma come un test di validazione pre-training volto a identificare potenziali crash dei job prima che inizino i processi di addestramento costosi. L'adozione di questi strumenti permette ai provider cloud di integrare capacità di gestione delle AI factory direttamente nelle loro piattaforme multi-tenant. [1]
DSX OS nell’illustrazione ufficiale NVIDIA dedicata alla gestione delle AI factory. Fonte: NVIDIA
Networking: USFP e l'interoperabilità Falcon
Nel settore del networking, NVIDIA e Cisco hanno annunciato lo standard USFP (Ultra-Dense Small Form Factor Pluggable), un modulo per fabric a 400Gb/s per lane. L'USFP quadruplica la densità di banda rispetto alle ottiche tradizionali a 200Gb/s, mantenendo un footprint simile al formato OSFP e migliorando l'efficienza energetica di circa 1.3x. Parallelamente, è stato annunciato il supporto per il protocollo Falcon Transport su future ConnectX-10 SuperNICs e BlueField DPUs, per migliorare l'efficienza del trasporto dati su reti Ethernet. [1]
Il supporto per Falcon non è attivo sui dispositivi attuali, ma è previsto per le generazioni future di hardware. L'importanza di questo standard risiede nell'interoperabilità: permette a NIC NVIDIA e Google di comunicare su un trasporto comune pur mantenendo le interfacce di programmazione RDMA standard. Per quanto riguarda la scalabilità oltre i 100.000 GPU, questa è resa possibile dalla tecnologia Spectrum-X Multiplane, che distribuisce il traffico su otto piani indipendenti per ridurre i livelli di switch e i costi. L'adozione combinata di USFP e Multiplane permette quindi di scalare la rete riducendo la latenza e i consumi, a patto di aggiornare l'hardware ai moduli compatibili quando disponibili. [1]
Dalla lettura all'azione
Da mettere in pratica
Verificare se il layout del data center supporta l'alimentazione a 800VDC per evitare colli di bottiglia nel cablaggio.
Valutare l'integrazione di Vera CPU separatamente da NVL72 per i carichi di orchestrazione agentica.
Valutare i test del Cluster Readiness Engine prima di avviare carichi di addestramento.
Distinguere le specifiche annunciate di USFP dalla disponibilità dei moduli compatibili.
Analizzare l'impatto del raffreddamento a liquido blind-mate MGX 1.2 sui tempi di manutenzione dei rack.
Analisi dell'Opzione Fibra 10 Giga lanciata il 12 ottobre 2026: costi aggiuntivi di 5€/mese, velocità nominali fino a 10 Gbps e requisiti hardware necessari tra cui Modem Seven X e ONT.
Annunciato il 12 ottobre 2026, Maia 300 è l'acceleratore di terza generazione di Microsoft per l'inferenza agentica cloud. Integra HBM4 e architettura a chiplet, con produzione prevista per il 2027.
Google presenta Fitbit Edge: display Hybrid OLED, prezzo italiano da 179,99 euro e autonomia dichiarata fino a sette giorni. Le differenze rispetto a Fitbit Air e Pixel Watch, con requisiti e limiti da conoscere.

Parliamone
Hai un’esperienza da condividere o una domanda? Scrivi un commento pertinente, senza pubblicità o link.