Microsoft Maia 300: HBM4, chiplet e rack da 96 acceleratori per l’inferenza AI
Annunciato il 12 ottobre 2026, Maia 300 è l'acceleratore di terza generazione di Microsoft per l'inferenza agentica cloud. Integra HBM4 e architettura a chiplet, con produzione prevista per il 2027.
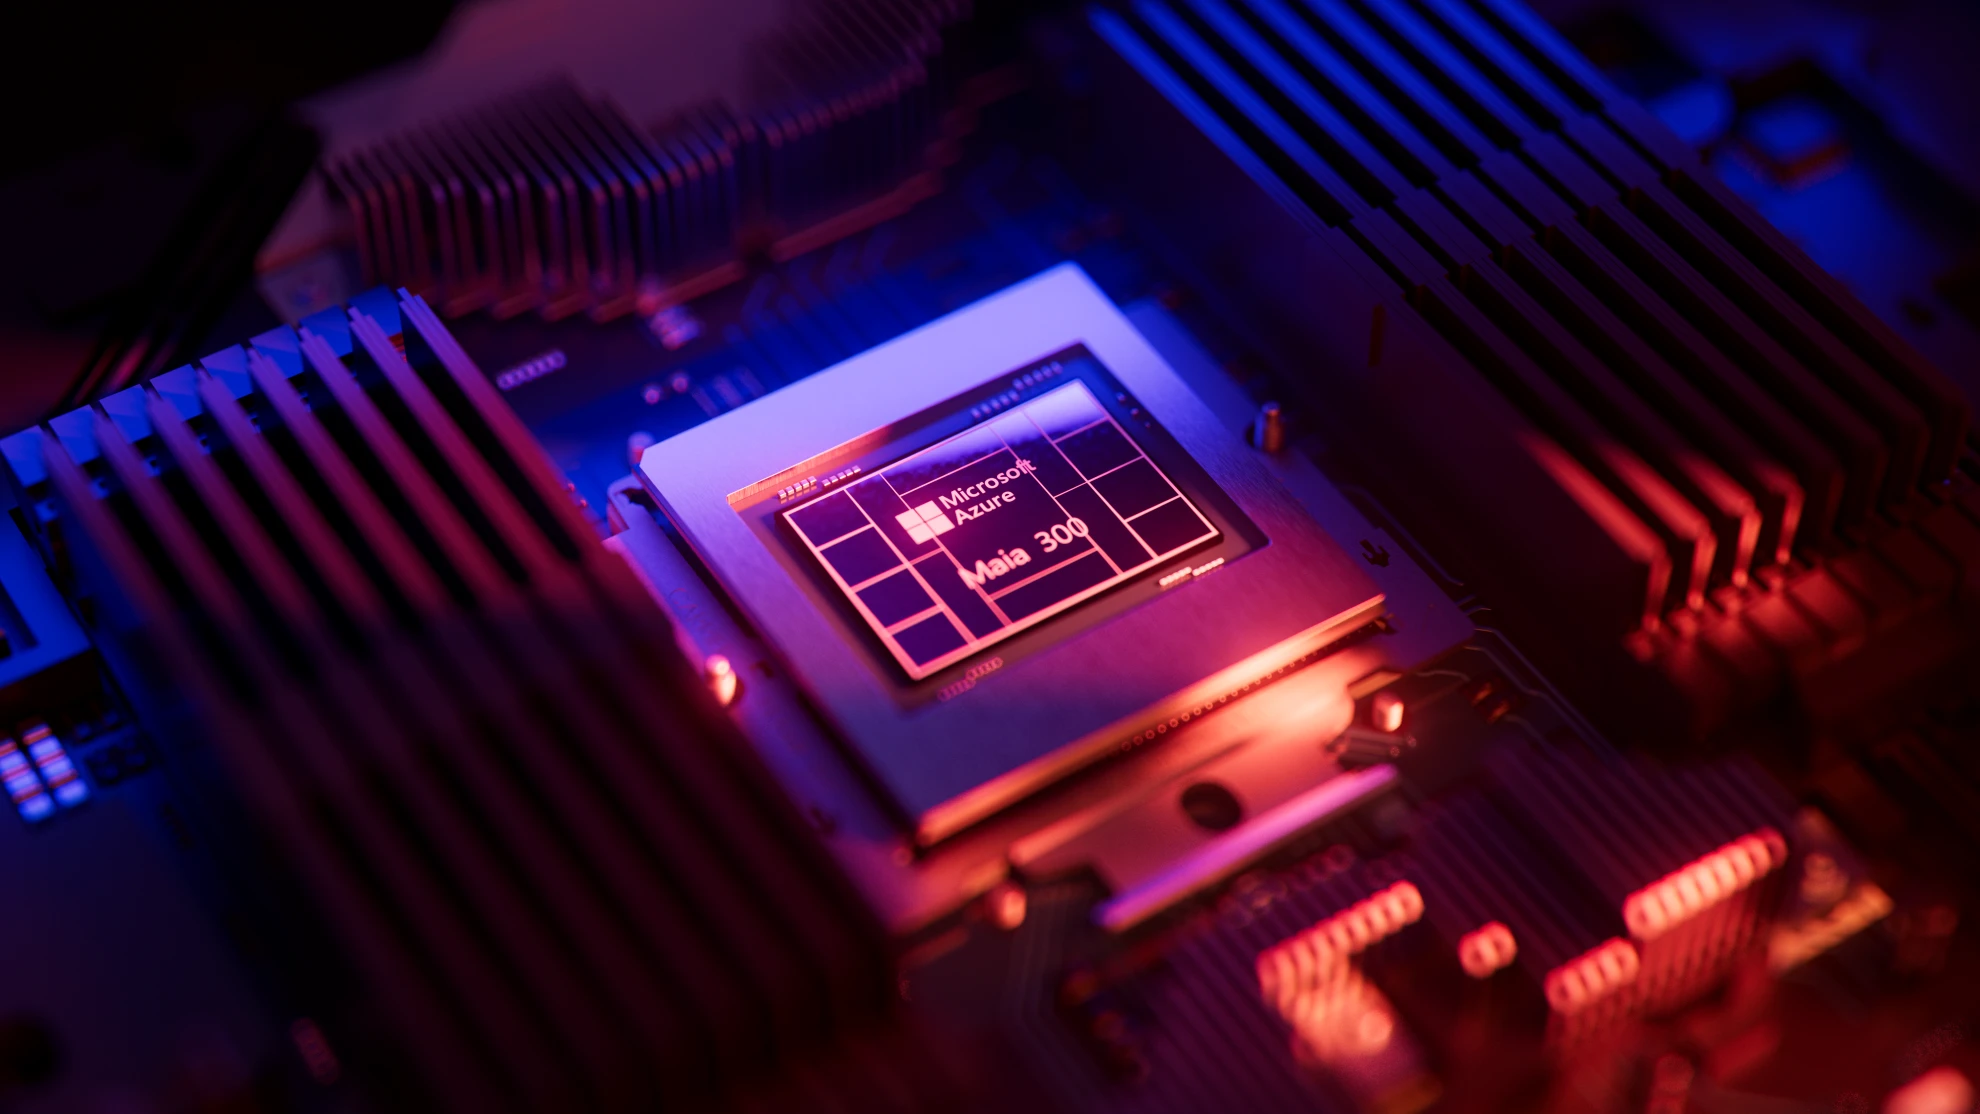
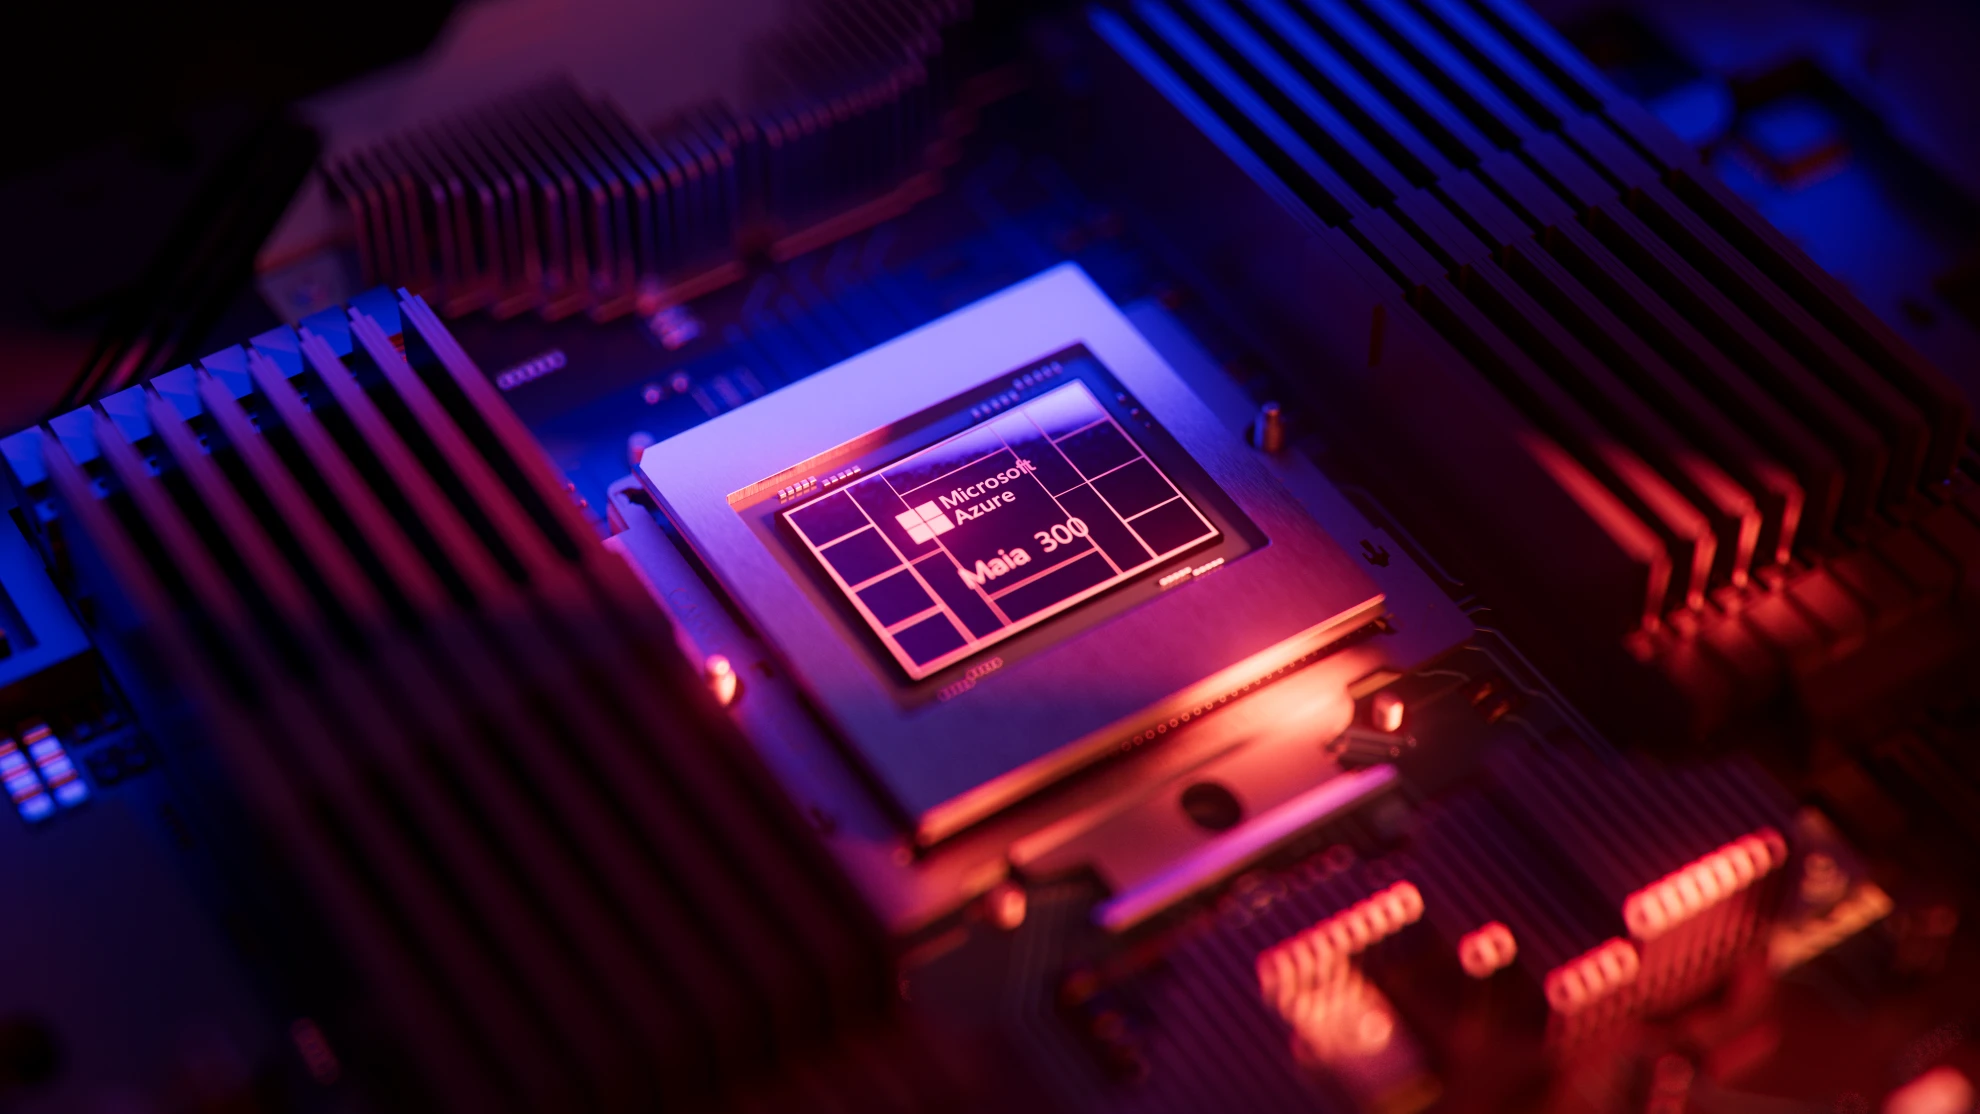
Maia 300 nella fotografia ufficiale Microsoft del prototipo: i deployment di produzione sono previsti nel 2027.Microsoft Azure · immagine ufficialeFonte dell’immagine
Obiettivo: l'inferenza agentica su scala cloud
Il 12 ottobre 2026 Microsoft ha presentato Maia 300, la terza generazione della sua famiglia di acceleratori AI. A differenza delle GPU retail, questo sistema è progettato seguendo una filosofia architettonica volta a ottimizzare l'intero sistema per l'inferenza di Large Language Models (LLM) su scala cloud, con l'obiettivo di massimizzare l'efficienza in termini di token per watt e per dollaro. Il sistema è pensato specificamente per supportare i carichi di lavoro 'agentici', ovvero processi che richiedono esecuzioni multi-step, l'uso di strumenti esterni e la gestione di contesti molto lunghi, elementi che alterano significativamente il profilo computazionale e l'intensità aritmetica dell'inferenza rispetto ai modelli tradizionali. [1]
Mentre Maia 200 è già operativa per carichi di produzione come Microsoft Copilot, e sarà estesa a GitHub Copilot e Microsoft Foundry entro la fine dell'anno, Maia 300 entrerà in produzione nel 2027. Questa distinzione temporale è fondamentale: Maia 300 non rappresenta un semplice aggiornamento software, ma una ridefinizione hardware volta a eliminare i colli di bottiglia nel movimento dei dati. Tale evoluzione permetterà a Microsoft di scalare l'infrastruttura verso deployment multi-gigawatt a partire dal 2027, posizionando Maia come il sistema di inferenza primario per l'intera gamma di prodotti e servizi Microsoft. [2]
Maia 300 nella fotografia ufficiale Microsoft del prototipo: i deployment di produzione sono previsti nel 2027. Fonte: Microsoft Azure
Architettura a chiplet e gestione NUMA
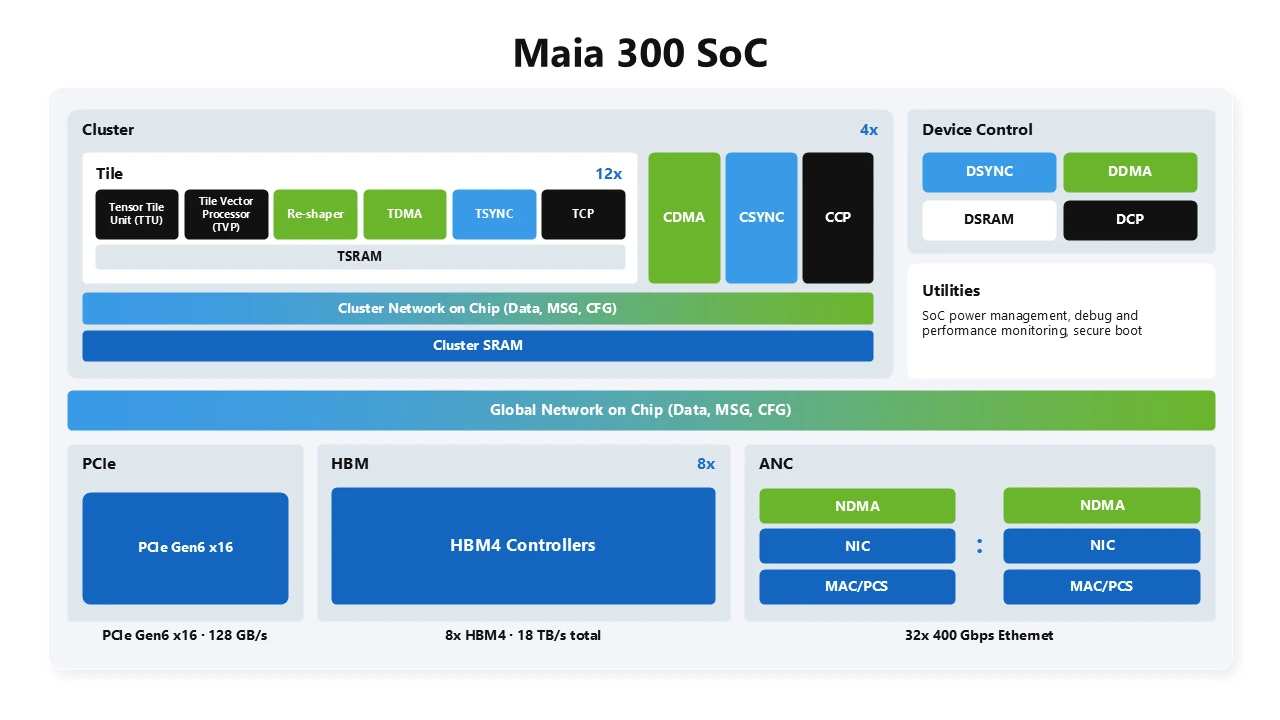
Il cuore di Maia 300 è un'architettura multi-chiplet che separa le funzioni di calcolo da quelle di I/O e controllo della memoria. Il compute è realizzato utilizzando il processo TSMC N2P, scelto per massimizzare le prestazioni per watt, mentre i controller di memoria e le funzioni di I/O sono alloggiati su die ottimizzati specificamente per banda, connettività e costi. Questo approccio permette di dedicare una porzione maggiore di area di silicio al calcolo puro, coordinando il movimento dei dati tramite la Software Defined Locally Accessed Dataflow Architecture (SDLA), che separa il percorso di controllo dall'esecuzione dei dati per ottimizzare l'efficienza energetica complessiva. [1]
Una novità cruciale è il passaggio da un'organizzazione della memoria Uniform Memory Access (UMA) a una Non-Uniform Memory Access (NUMA) tra i chiplet. In termini pratici, ogni regione di calcolo dispone di memoria nelle immediate vicinanze, permettendo al software di posizionare i dati esattamente dove vengono utilizzati. Questo cambiamento mira a ridurre drasticamente la distanza percorsa dai dati all'interno del System-on-Chip (SoC), riducendo l'energia consumata per ogni operazione di spostamento. Tale ottimizzazione è determinante per l'inferenza di contesti lunghi e ragionamenti intensivi, dove la località del dato è il fattore principale per evitare latenze di memoria. [1]
Infografica · La novità, in tre punti. Fonti: [1]Leggi il contenuto dello schema
Sintesi dei fatti documentati nell’articolo. I riferimenti sono riportati sotto lo schema.
Punto 1 · Obiettivo: l'inferenza agentica su scala cloud: Il 12 ottobre 2026 Microsoft ha presentato Maia 300, la terza generazione della sua famiglia di acceleratori AI.
Punto 2 · Architettura a chiplet e gestione NUMA: Il cuore di Maia 300 è un'architettura multi-chiplet che separa le funzioni di calcolo da quelle di I/O e controllo della memoria.
Punto 3 · Memoria HBM4 e precisione ridotta: Per alimentare le unità di calcolo, Maia 300 integra otto stack di memoria HBM4, raggiungendo una capacità di 288 GB e una larghezza di banda di 18 TB/s per singolo acceleratore.
Schema ufficiale del system-on-chip Maia 300: chiplet di calcolo, memoria e I/O. Fonte: Microsoft Azure
Memoria HBM4 e precisione ridotta
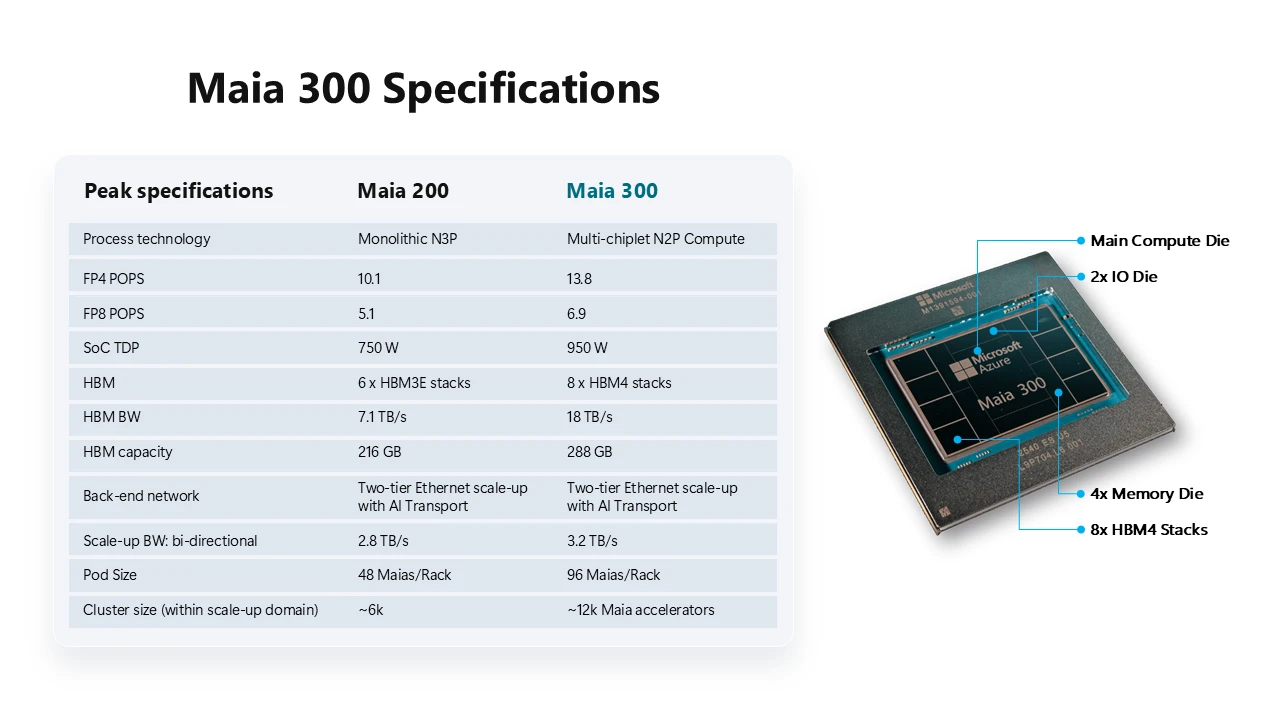
Per alimentare le unità di calcolo, Maia 300 integra otto stack di memoria HBM4, raggiungendo una capacità di 288 GB e una larghezza di banda di 18 TB/s per singolo acceleratore. Rispetto alla generazione precedente (Maia 200), ciò rappresenta un incremento della banda di 2,5 volte e della capacità del 33%. L'efficienza è ulteriormente potenziata da un miglioramento della banda HBM per watt, che risulta circa doppia rispetto a Maia 200. Questo incremento è fondamentale per mantenere lo stato KV (Key-Value) vicino alle unità di calcolo durante la generazione dei token, riducendo i tempi di attesa del processore e migliorando il throughput complessivo. [1]
Parallelamente all'hardware, Microsoft introduce nuovi formati di precisione ridotta, tra cui MXFP4 e formati di storage sub-3-bit, supportati da conversioni accelerate via hardware. L'obiettivo non è solo ridurre l'occupazione di memoria, ma diminuire il numero di byte spostati per ogni token generato, permettendo di supportare modelli più grandi e un numero maggiore di sessioni concurrenti all'interno dello stesso budget energetico. È importante notare che la riduzione dei bit non garantisce automaticamente che la qualità del modello resti invariata; l'efficacia di tali formati dipende dalla specifica implementazione del modello e dalla tolleranza all'errore della precisione ridotta. [1]
Specifiche tecniche Maia 300 nell’infografica ufficiale Microsoft. I valori di picco e i confronti sono dichiarazioni del produttore. Fonte: Microsoft Azure
Il rack da 96 acceleratori e l'efficienza termica
La densità di calcolo viene raddoppiata a livello di rack: Maia 300 integra 96 acceleratori distribuiti in 24 tray (quattro acceleratori per tray) all'interno di un singolo rack con un budget energetico di 167 kW. Un dettaglio tecnico rilevante è l'eliminazione dei tray host separati; ogni tray include ora il proprio processore host, memoria e storage. Questa integrazione permette di gestire risorse termiche e power come un unico sistema, ottimizzando lo spazio fisico e la capacità di inferenza per rack, semplificando inoltre la distribuzione dell'energia tramite un'architettura a busbar da 50 V che garantisce ridondanza operativa. [1]
Il sistema di raffreddamento è di tipo ibrido: il raffreddamento a liquido rimuove oltre l'80% del carico termico proveniente da acceleratori, regolatori di tensione e switch ASIC, mentre il raffreddamento ad aria gestisce i componenti ancillari come storage e memoria. Questa flessibilità permette a Maia 300 di essere installata sia in datacenter dotati di acqua di facility che in ambienti raffreddati ad aria tramite l'uso di unità scambiatori di calore. Tale versatilità è pensata per facilitare il deployment su larga scala in diverse tipologie di infrastrutture, sebbene l'efficienza massima sia legata alla disponibilità di raffreddamento a liquido. [1]
Networking: dal Pod al Superpod
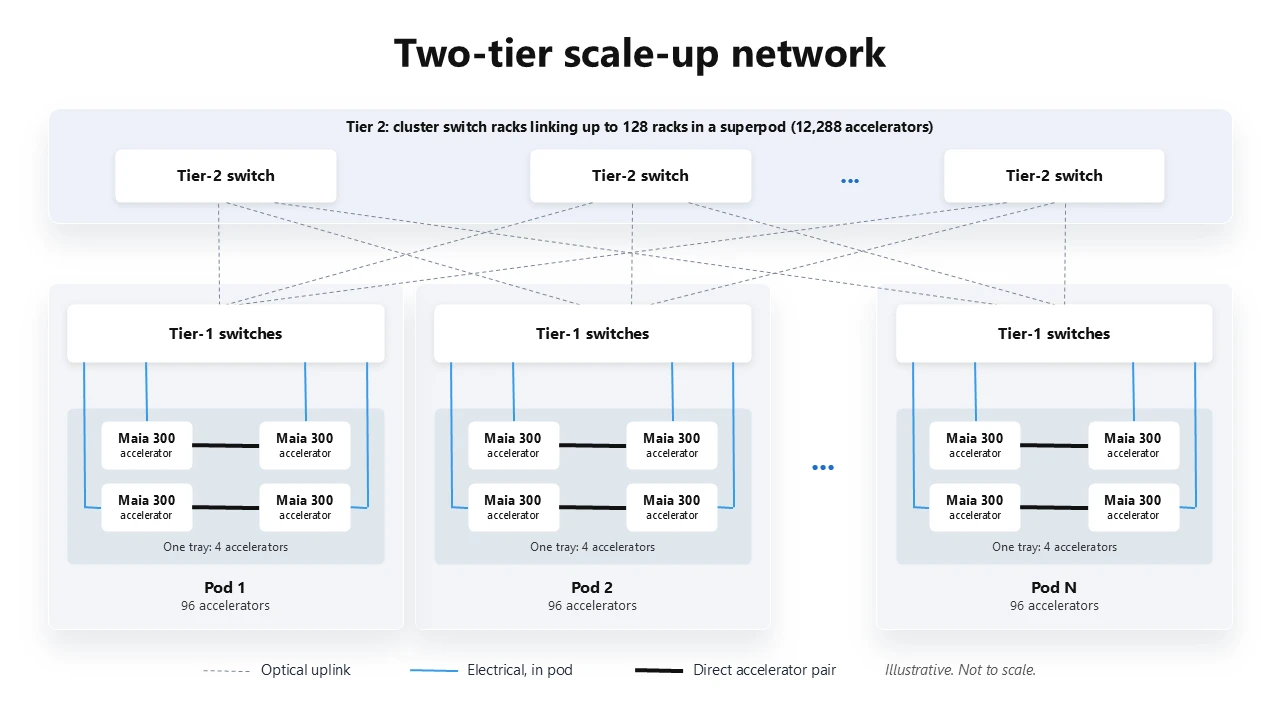
Il networking di Maia 300 è un'estensione nativa dell'architettura SDLA, basata su un trasporto AI custom implementato su Ethernet. La struttura è organizzata su due livelli: all'interno del rack, i 96 acceleratori sono collegati tramite link elettrici in una topologia half-switched per ridurre costi e consumi energetici. Per scalare oltre il singolo rack, vengono utilizzati switch ottici che collegano fino a 128 rack, formando un 'superpod' di 12.288 acceleratori che operano come un unico sistema logico. Questo permette comunicazioni dirette tra qualsiasi acceleratore del superpod senza l'intervento dell'host o di NIC di scale-out discrete. [1]
La gestione della latenza è strutturata in tre domini: coppie direttamente connesse, acceleratori all'interno dello stesso pod (un salto di switch) e acceleratori tra pod diversi (tre salti di switch). Il software può quindi mantenere il traffico tensor-parallel, estremamente sensibile alla latenza, nei domini più veloci. Inoltre, la banda tra i peer nel superpod può raggiungere i 750 GB/s, a condizione che solo un sottoinsieme di acceleratori debba comunicare tra rack diversi. Questo design evita colli di bottiglia globali e permette una distribuzione flessibile dei carichi di lavoro, riducendo gli acceleratori 'stranded' quando le dimensioni del job non coincidono con la configurazione fisica del rack. [1]
Topologia ufficiale di rete Maia 300: dal rack con 96 acceleratori al superpod. Fonte: Microsoft Azure
Analisi delle prestazioni e limiti di adozione
Microsoft dichiara che Maia 300 offre un throughput di token per rack fino a sette volte superiore rispetto a Maia 200 e prestazioni per watt oltre 2,5 volte superiori. Tuttavia, è fondamentale contestualizzare questi dati: il rack di Maia 300 contiene il doppio degli acceleratori rispetto al precedente, pertanto il fattore 7× non indica un incremento lineare della potenza del singolo chip, ma l'efficienza dell'intero sistema di rack. Per quanto riguarda il confronto con le GPU, viene citato un incremento del 40% di token per megawatt, ma l'annuncio non fornisce una configurazione di riferimento dettagliata o un dataset specifico per riprodurre tale misura in modo indipendente. [1][2]
Per valutare l'adozione pratica, consideriamo l'esempio illustrativo della gestione di prompt molto lunghi in un'architettura agentica. In un sistema tradizionale, il trasferimento dello stato KV tra le fasi di prefill e decode spesso richiede l'intervento dell'host o di NIC esterne, introducendo latenze significative. In Maia 300, questo flusso avviene direttamente sul fabric di scale-up, eliminando passaggi intermedi. Un architetto di sistema dovrebbe quindi considerare Maia 300 se l'applicazione richiede un'inferenza con alta frequenza di token e contesti estesi, dove il collo di bottiglia non è più la potenza di calcolo bruta (TFLOPS), ma la larghezza di banda della memoria e la latenza di rete tra i nodi. [1]
Dalla lettura all'azione
Da mettere in pratica
Verificare la disponibilità di infrastrutture di raffreddamento a liquido per supportare l'80% del carico termico del rack.
Valutare l'impatto dei formati MXFP4 e sub-3-bit sulla precisione dei modelli specifici per l'applicazione.
Distinguere Maia 200, già in produzione per Copilot, da Maia 300, prevista per il 2027.
Analizzare la distribuzione dei carichi tra prefill e decode per sfruttare il fabric di scale-up senza l'intervento dell'host.
Considerare la topologia NUMA per l'ottimizzazione del posizionamento dei dati tramite software per ridurre la latenza.
Analisi dell'Opzione Fibra 10 Giga lanciata il 12 ottobre 2026: costi aggiuntivi di 5€/mese, velocità nominali fino a 10 Gbps e requisiti hardware necessari tra cui Modem Seven X e ONT.
NVIDIA condivide i progetti dei rack Vera Rubin tramite MGX e OCP. Ecco cosa cambia per alimentazione, raffreddamento, rete e gestione delle infrastrutture, e quali elementi restano futuri.
Google presenta Fitbit Edge: display Hybrid OLED, prezzo italiano da 179,99 euro e autonomia dichiarata fino a sette giorni. Le differenze rispetto a Fitbit Air e Pixel Watch, con requisiti e limiti da conoscere.

Parliamone
Hai un’esperienza da condividere o una domanda? Scrivi un commento pertinente, senza pubblicità o link.