NVIDIA RTX Spark: l'architettura Superchip per l'IA locale su Windows PC
NVIDIA e Microsoft lanciano RTX Spark, un superchip che integra GPU Blackwell e CPU Grace per permettere l'esecuzione locale di agenti AI complessi su laptop e desktop Windows, riducendo la dipendenza dal cloud.
Illustrazione editoriale di un’infrastruttura cloud.giuseppegambino.it · illustrazione originale
L'era degli agenti AI locali
Il 7 ottobre 2026, NVIDIA e Microsoft hanno annunciato l'introduzione di RTX Spark, una piattaforma hardware progettata per spostare l'esecuzione degli agenti AI dal cloud direttamente sui PC Windows. Questa evoluzione mira a trasformare il computer personale in un assistente privato capace di gestire flussi di lavoro complessi in modo autonomo, garantendo che i dati sensibili rimangano sul dispositivo dell'utente senza necessità di inviarli a server esterni. [1]
Per rendere possibile questa transizione, Microsoft ha introdotto i Microsoft Execution Containers (MXC). Si tratta di un'infrastruttura a livello di sistema operativo che permette agli agenti AI di girare in background in modo persistente e sicuro, sotto il controllo diretto di Windows, evitando che i processi di automazione interferiscano con la stabilità del sistema o compromettano la privacy. [1]
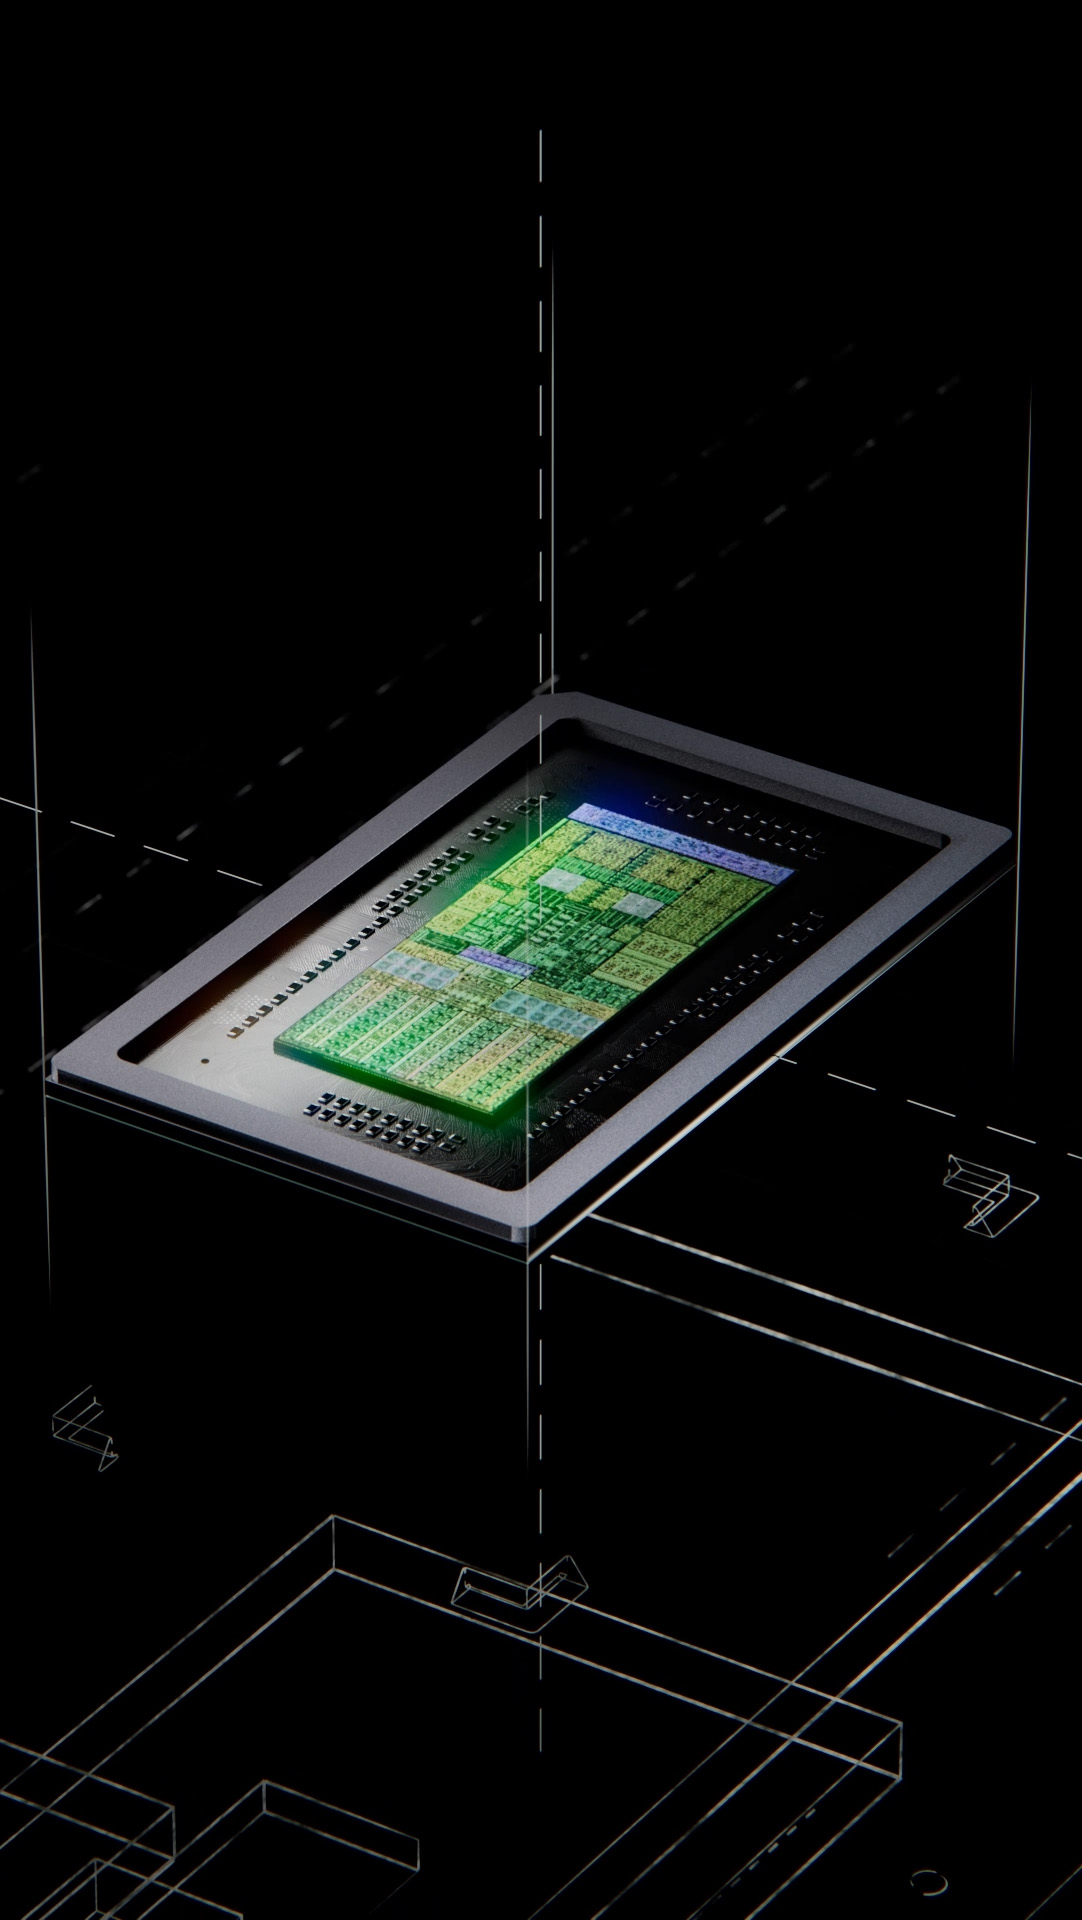
Figura tecnica originale della fonte ufficiale; per dati e condizioni fare riferimento al documento collegato. Fonte: www.nvidia.com
Specifiche tecniche del Superchip
Il cuore di RTX Spark è un superchip che combina una GPU NVIDIA Blackwell RTX, con un massimo di 6.144 core, e una CPU NVIDIA Grace fino a 20 core. La caratteristica distintiva è l'adozione di una memoria unificata fino a 128 GB, collegata a una velocità di 600 GB/s, che permette di caricare modelli AI che normalmente richiederebbero infrastrutture server, raggiungendo prestazioni di calcolo AI fino a un petaflop in FP4. [1][4]
Questa configurazione hardware permette l'esecuzione locale di modelli di grandi dimensioni, come Qwen 3.8 Flash Next (125 miliardi di parametri), senza i costi per prompt o le latenze tipiche delle API cloud. Per i creatori e i gamer, l'integrazione include Tensor Core di quinta generazione con supporto NVFP4, DLSS 5 e ray tracing, ottimizzando sia la produzione video che l'esperienza di gioco a 1440p. [1][4]
Infografica · Architettura NVIDIA RTX Spark. Fonti: [1]Leggi il contenuto dello schema
Integrazione hardware per l'esecuzione di agenti AI locali su Windows
Hardware · Superchip Blackwell + Grace: Unione di GPU Blackwell RTX e CPU Grace con memoria unificata fino a 128GB per gestire modelli AI di grandi dimensioni.
Software · Piattaforma CUDA e MXC: Utilizzo dello stack CUDA per lo sviluppo e dei Microsoft Execution Containers per l'esecuzione sicura di agenti in background.
Output · Agenti AI Locali: Esecuzione di modelli fino a 120B-125B parametri senza dipendenza dal cloud e con protezione dei dati on-device.
Dispositivi e disponibilità
La tecnologia RTX Spark viene implementata in diverse categorie di hardware. I laptop, tra cui il Surface Laptop Ultra di Microsoft, sono aperti ai preordini e saranno disponibili a partire dal 16 ottobre 2026. Altri produttori come ASUS, Dell, HP, Lenovo, MSI e Gigabyte integreranno il superchip nei loro design, spaziando da laptop sottili a workstation compatte. [1][4]
Per i professionisti dello sviluppo, è stato presentato il Surface RTX Spark Dev Box, un sistema focalizzato sulla creazione di agenti AI che include strumenti preconfigurati come VS Code, GitHub Copilot CLI e WSL. Parallelamente, NVIDIA ha anticipato la DGX Station per Windows, un supercomputer da scrivania basato su GB300 Grace Blackwell Ultra, capace di gestire modelli fino a un trilione di parametri con 748 GB di memoria coerente. [1][5]
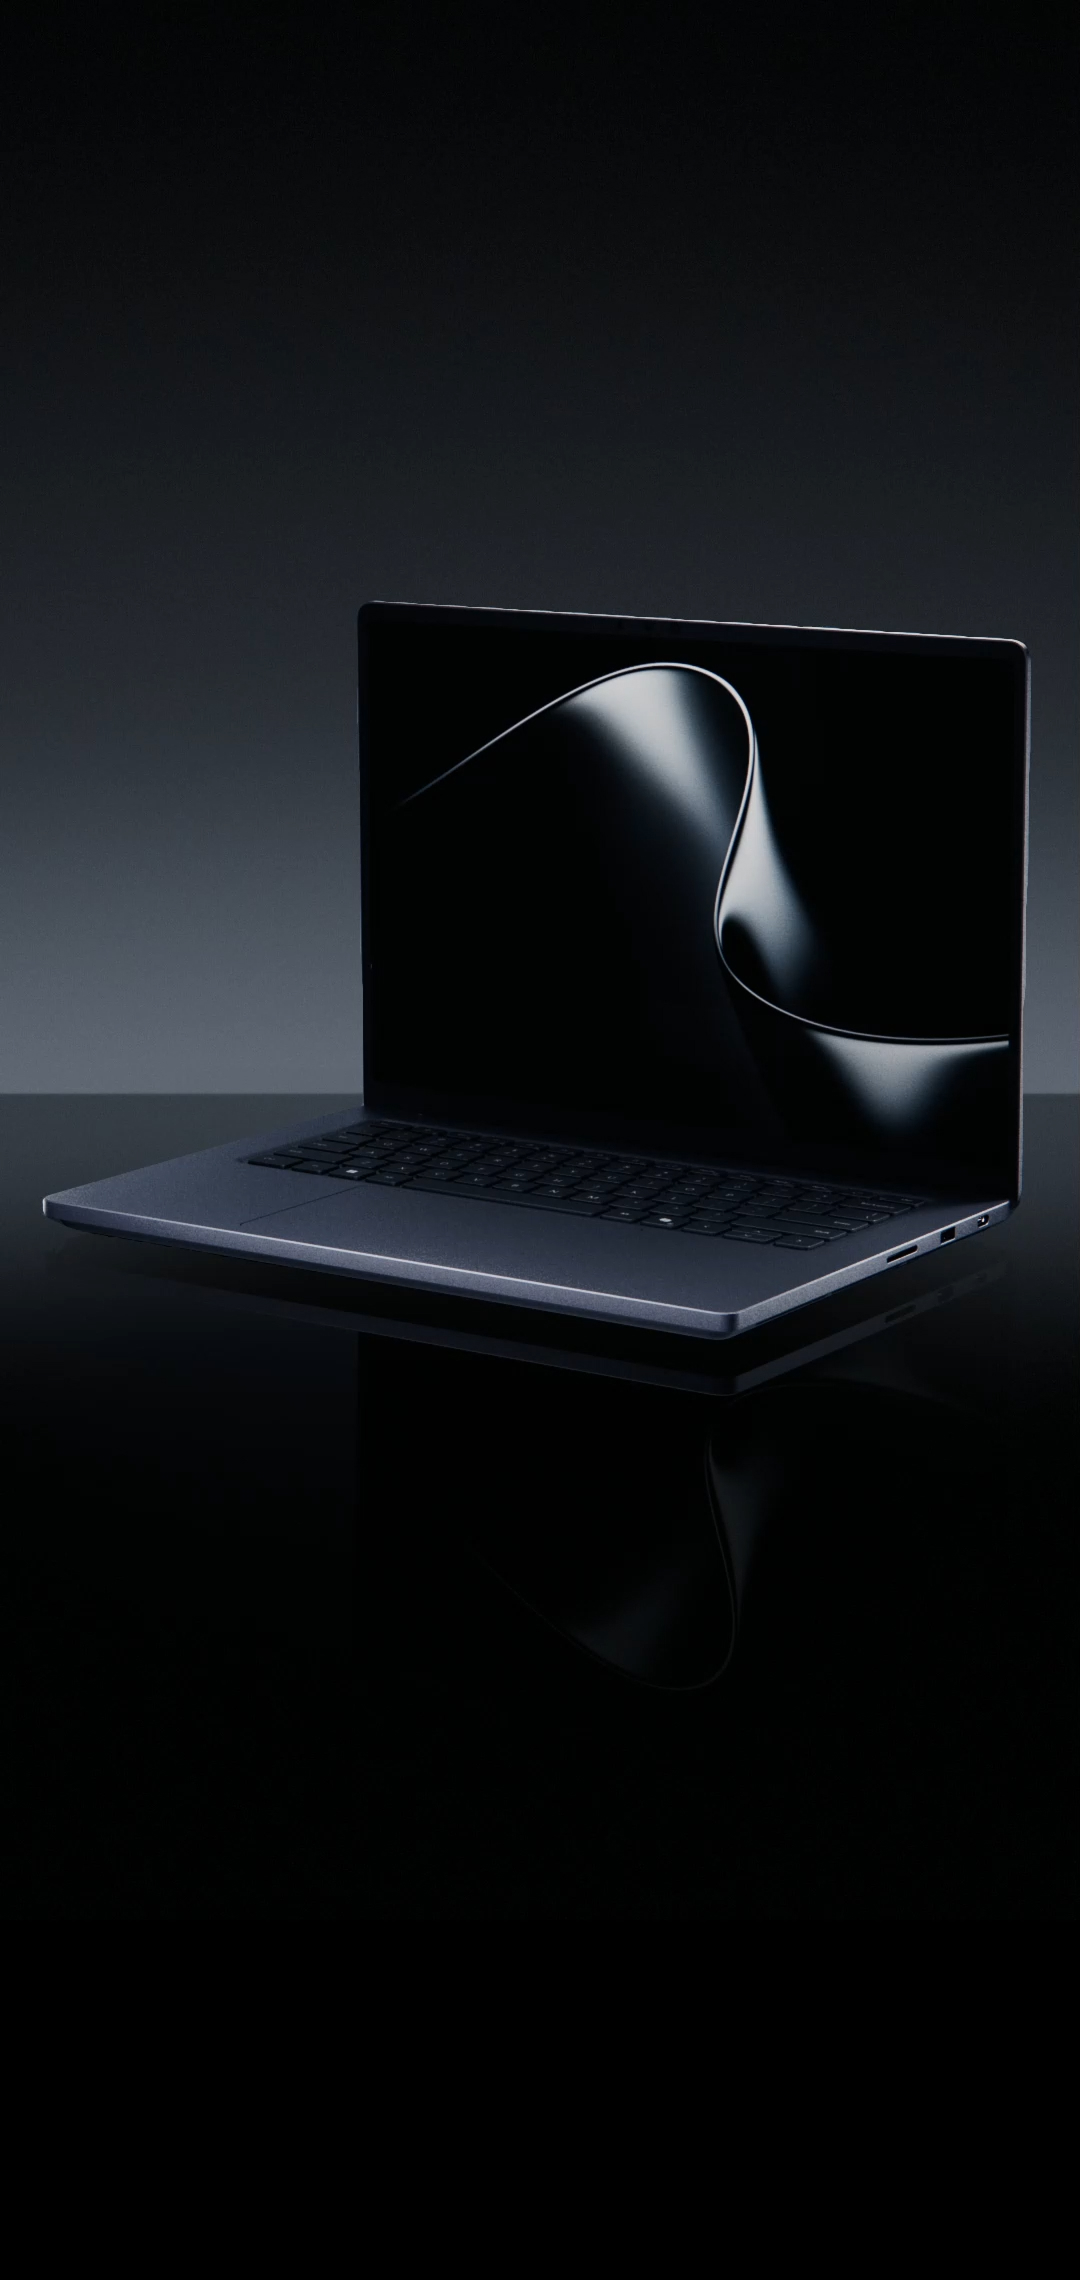
Immagine del prodotto pubblicata nella fonte ufficiale; non rappresenta una misura di prestazioni. Fonte: Microsoft
Analisi del flusso di lavoro: Cloud vs Locale
Il passaggio all'elaborazione locale tramite RTX Spark modifica radicalmente il ciclo di sviluppo AI. In precedenza, i ricercatori dovevano alternare tra ambienti Linux per il calcolo pesante e Windows per la produttività, oppure dipendere da cluster cloud costosi. Con l'integrazione di CUDA su Windows e la memoria unificata, è possibile prototipare, testare e fare l'inferenza di modelli massivi direttamente sulla macchina di lavoro, riducendo i costi per token e i tempi di iterazione. [1][5]
Un esempio operativo di adozione riguarda lo sviluppo di un agente per l'analisi di codice proprietario: invece di caricare l'intero repository su un server esterno, lo sviluppatore può utilizzare un Surface Laptop Ultra per eseguire un modello da 120B parametri localmente. Il criterio di scelta per l'adozione risiede nel volume di dati sensibili trattati e nella necessità di bassa latenza; chi lavora su modelli di piccole dimensioni o ha accesso a infrastrutture cloud aziendali consolidate potrebbe non trovare immediato l'incentivo all'aggiornamento hardware. [3][5]
Limiti e vincoli tecnici
Nonostante le elevate prestazioni, l'implementazione di RTX Spark comporta sfide termiche significative. Microsoft ha dovuto progettare per il Surface Laptop Ultra il sistema termico più grande mai realizzato per la linea, con ventole più grandi per aumentare la capacità di dissipazione di 2,5 volte rispetto al modello precedente da 15 pollici, al fine di mantenere costanti le prestazioni durante i carichi di lavoro AI intensivi. [3]
Un altro limite riguarda la segmentazione delle prestazioni tra le diverse versioni del chip. Mentre la versione N1X offre fino a 128 GB di memoria LPDDR5X e 6.144 core GPU, esistono configurazioni inferiori che limitano la memoria a 64 GB e i core a 5.120, influenzando direttamente la dimensione massima dei modelli AI che possono essere caricati interamente in memoria senza ricorrere allo swapping o al cloud. [4]
Immagine del prodotto pubblicata nella fonte ufficiale; non rappresenta una misura di prestazioni. Fonte: Microsoft
Criteri di adozione per professionisti
La scelta di investire in hardware RTX Spark dovrebbe basarsi sulla natura dei carichi di lavoro. I developer che necessitano di fine-tuning locale e test di agenti senza dipendenze esterne troveranno nel Dev Box o nella DGX Station strumenti essenziali. Al contrario, i creatori di contenuti che utilizzano principalmente software di editing video o rendering 3D trarranno beneficio dalle nuove GPU Blackwell, ma potrebbero non necessitare della massima capacità di memoria unificata dedicata all'IA. [1][4][5]
È fondamentale valutare anche la compatibilità software: l'ecosistema RTX Spark si appoggia su Windows 11 e CUDA. Chi è abituato a toolchain Linux può continuare a utilizzare WSL (Windows Subsystem for Linux), ma il vero vantaggio risiede nell'integrazione nativa con le API di Windows e i container MXC, che permettono agli agenti di interagire con le applicazioni desktop in modo fluido e sicuro. [1][4]
Dalla lettura all'azione
Da mettere in pratica
Verificare se i modelli AI utilizzati superano i 60 miliardi di parametri per giustificare i 128GB di memoria.
Controllare la disponibilità dei Microsoft Execution Containers (MXC) nella versione di Windows 11 installata.
Valutare l'impatto termico e l'autonomia della batteria in caso di scelta di un laptop rispetto a un desktop compatto.
Confrontare i costi di abbonamento cloud AI annuali con l'investimento hardware iniziale del superchip.
Assicurarsi che i flussi di lavoro dipendano da CUDA per massimizzare l'efficienza della GPU Blackwell.
Il 5 ottobre 2026, Amazon Bedrock ha reso disponibile GLM 5.3 di Z.ai, un modello open-weight basato su architettura Mixture-of-Experts ottimizzato per l'ingegneria del software e il coding autonomo.
Dal 5 ottobre 2026, le istanze Amazon EC2 Hpc8a, basate su processori AMD EPYC di 5ª generazione, sono disponibili nella regione Asia Pacific (Singapore) per carichi HPC intensivi e a bassa latenza.
A partire dalla versione v1.35, Kubernetes rende cgroup v2 lo standard operativo, impedendo l'avvio del kubelet su nodi v1 per impostazione predefinita per migliorare l'isolamento e la gestione delle risorse.

Parliamone
Hai un’esperienza da condividere o una domanda? Scrivi un commento pertinente, senza pubblicità o link.