Mistral Large 4: cosa cambia con Le Chonk, tra API in anteprima e pesi in arrivo
Mistral Large 4 arriva in public preview: architettura MoE, testo e immagini, risultati sul coding e pesi attesi a fine ottobre. Analizziamo specifiche, divergenze nelle fonti e criteri per provarlo.
Illustrazione editoriale di una postazione di sviluppo e revisione del codice.giuseppegambino.it · illustrazione originale
L’API si può provare, i pesi devono ancora arrivare
Mistral ha presentato Large 4 il 6 ottobre 2026, usando il soprannome Le Chonk. La novità immediatamente accessibile è una public preview tramite API su Mistral Studio. Il rilascio dei pesi è invece annunciato per la fine del mese: le due disponibilità non coincidono. Questo dettaglio cambia il modo di valutare il prodotto. Oggi si può iniziare a sperimentare con il servizio ospitato; il lancio non permette ancora di trattare il modello come un pacchetto già scaricabile e installabile sulla propria infrastruttura. La data indicata per i pesi resta un impegno annunciato dal produttore. [1]
Per un team di sviluppo, la scelta pratica è separare un esperimento dall’adozione. L’esperimento può misurare la qualità delle risposte su problemi rappresentativi, senza costruire subito un’intera applicazione attorno al modello. L’adozione richiede invece di verificare condizioni del servizio, stabilità del comportamento e requisiti della propria organizzazione. Se il progetto dipende necessariamente dall’esecuzione interna, conviene preparare i casi di prova ma aspettare i materiali del rilascio dei pesi prima di decidere. Una promessa di disponibilità futura non risolve i vincoli di un sistema che deve andare in produzione oggi.
Un trilione di parametri non racconta tutta l’architettura
La scheda tecnica descrive una struttura Mixture-of-Experts, o MoE, con 1,05 trilioni di parametri totali, 52 miliardi attivi e un encoder visivo da 1,6 miliardi. L’annuncio usa invece la cifra arrotondata di un trilione e riporta 49 miliardi di parametri attivi. Questa divergenza va mantenuta visibile: le pagine consultate non spiegano come riconciliare i due conteggi attivi. Non attribuiamo quindi la differenza all’encoder visivo o ad altre componenti senza una prova. La scheda indica inoltre una finestra di contesto da un milione di token, una specifica distinta dalla dimensione dei parametri. [2][1]
Nel valutare questi numeri, è utile tenere separati tre interrogativi: quanti parametri contiene il modello, quanti ne vengono indicati come attivi e quanto testo può ricevere nel contesto. Non sono tre misure intercambiabili della qualità. Un contesto molto ampio, per esempio, non dimostra da solo che ogni informazione inserita verrà recuperata correttamente. Una prova ragionata deve collocare una risposta verificabile in punti diversi di un documento e controllare se il modello sa citarla. Allo stesso modo, i parametri attivi non bastano a ricavare il costo reale di una futura installazione: occorreranno specifiche di distribuzione e misure effettive.
Infografica · Mistral Large 4: disponibile e annunciato. Fonti: [1][2]Leggi il contenuto dello schema
L’accesso all’API e il rilascio dei pesi sono due fasi diverse.
Adesso · API in public preview: L’anteprima pubblica si può provare su Mistral Studio. I pesi non sono ancora rilasciati.
Scheda tecnica · 1,05T totali, 52B attivi: La scheda tecnica indica 52 miliardi attivi, da distinguere dai parametri totali.
Fine ottobre · Pesi annunciati, non ancora rilasciati: Mistral promette il rilascio entro fine mese. L’API di oggi non equivale ai pesi scaricabili.
Coding: leggere i benchmark senza mescolare i test
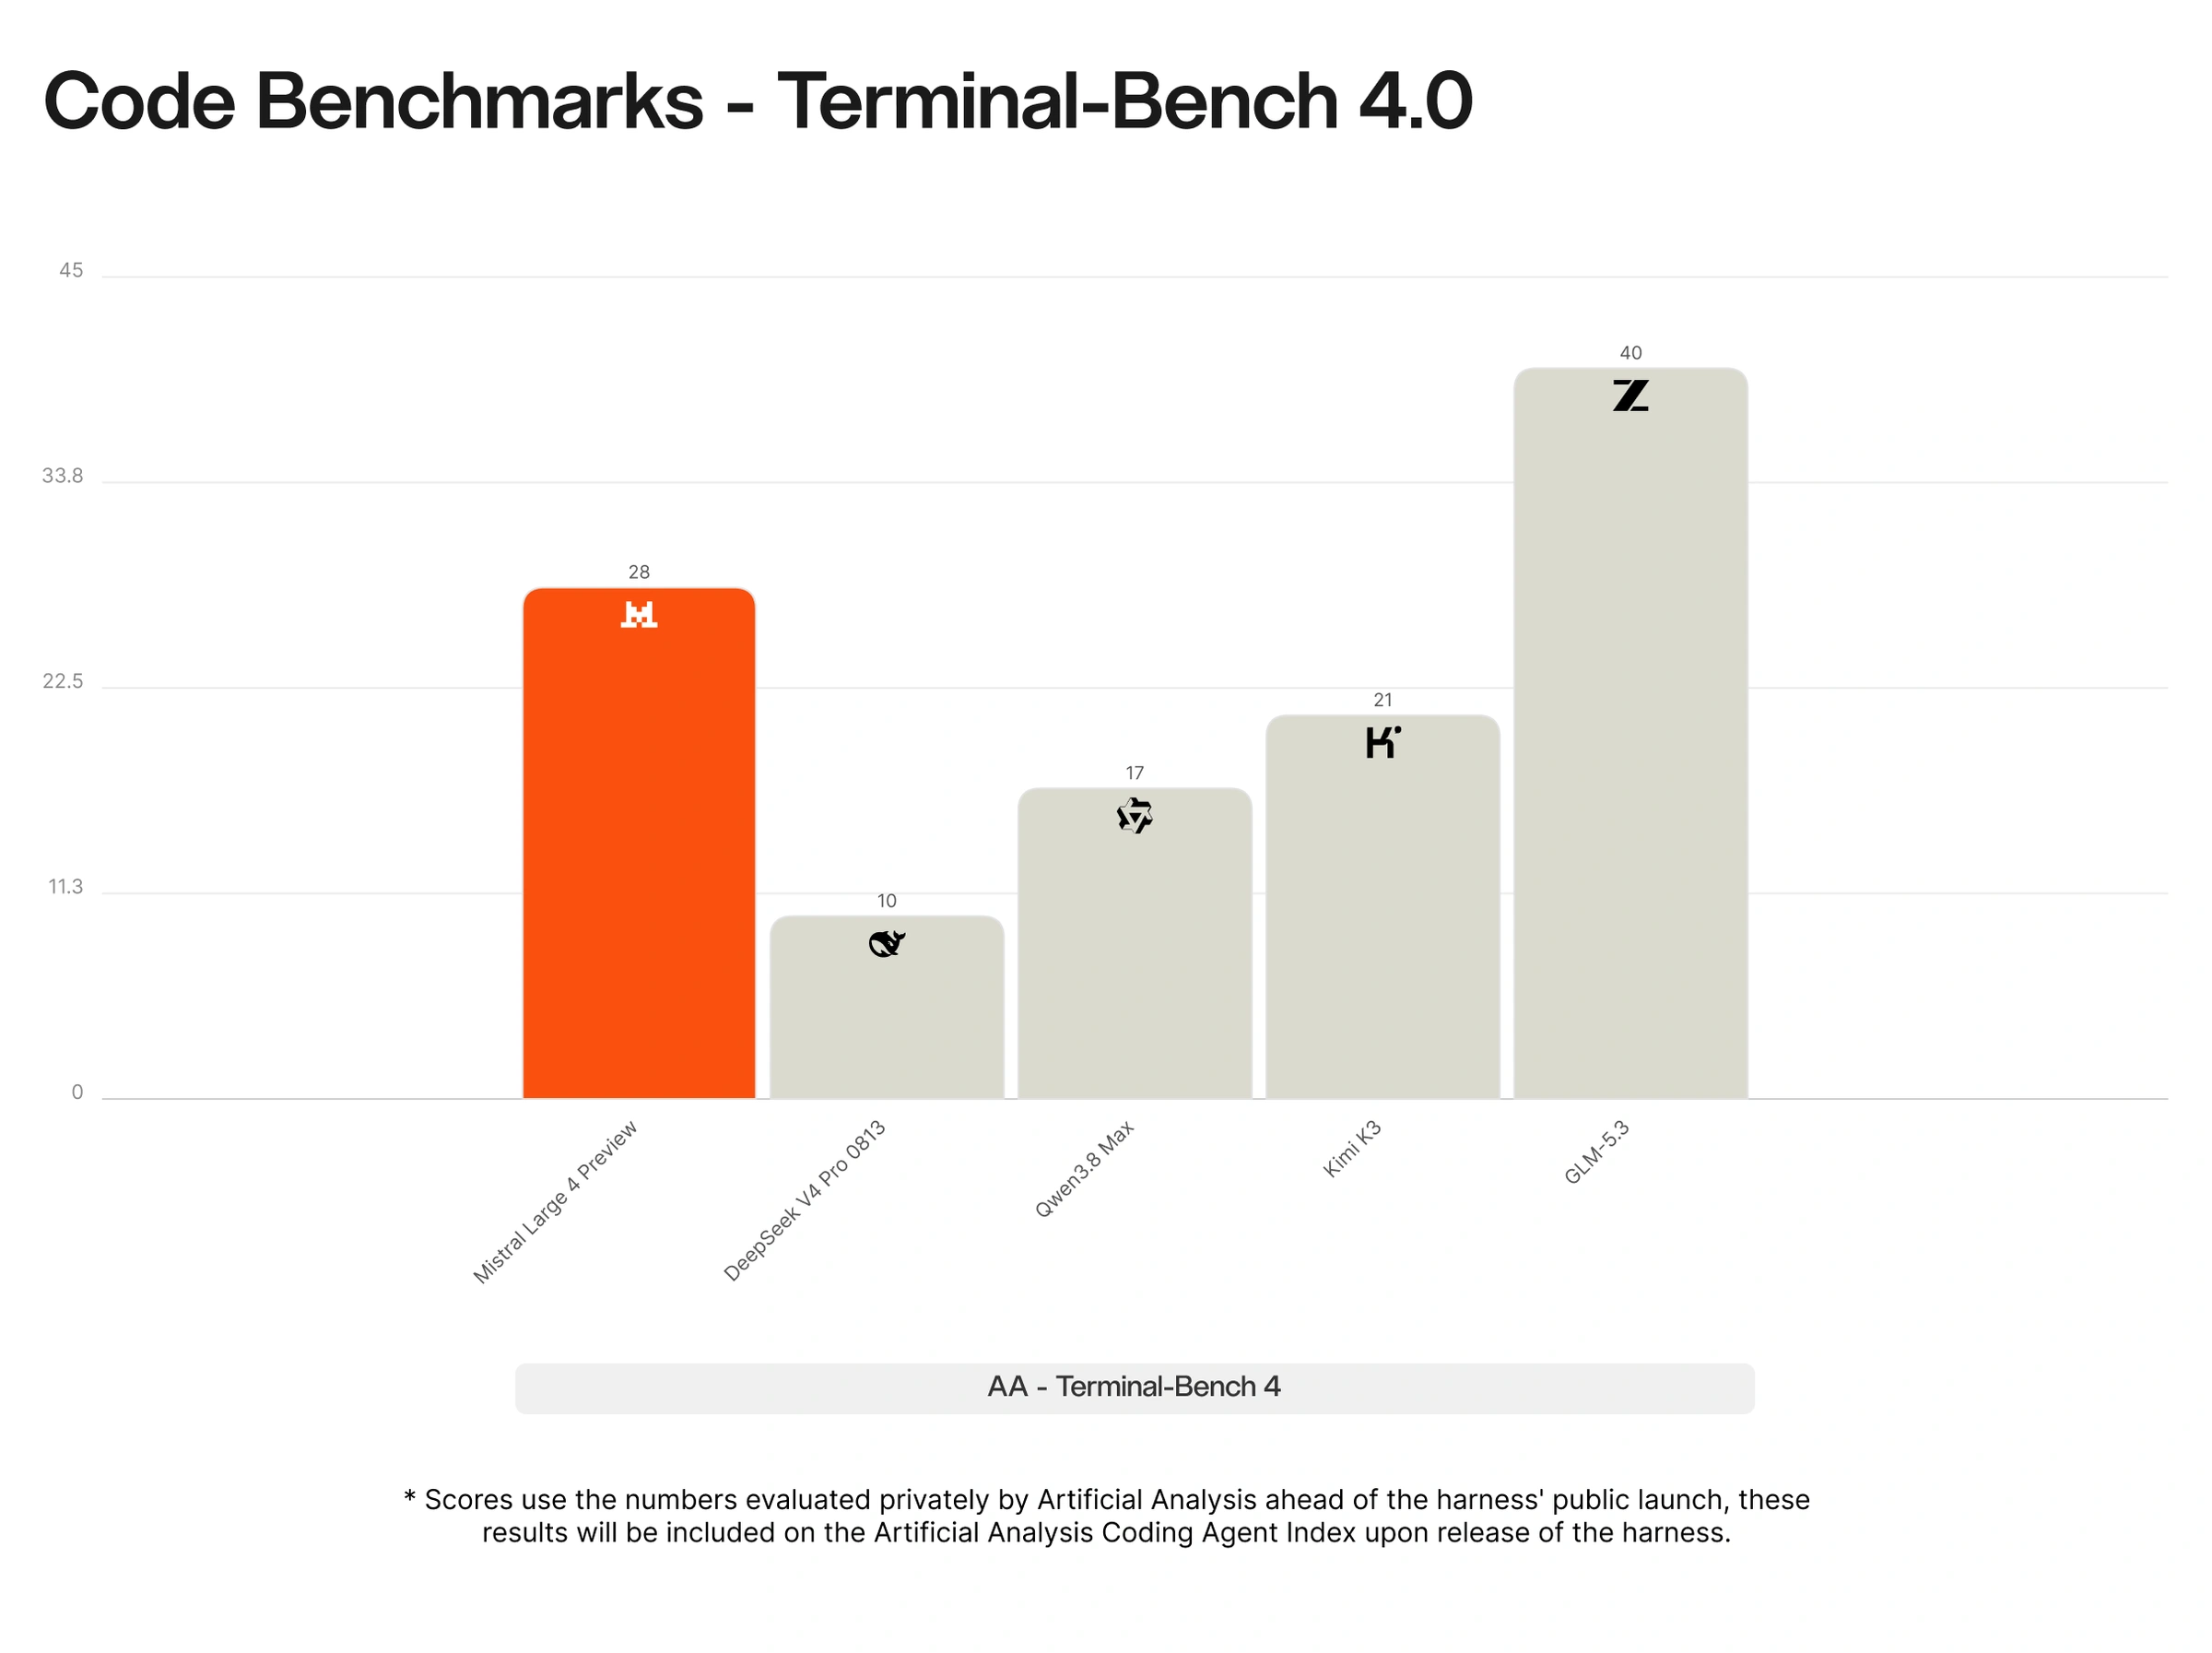
Mistral riporta il 61,7% su DeepSWE v1.1, il 59,4% su SWE-Atlas-QnA e il 28,3% su Terminal-Bench 4. Sono risultati dichiarati nell’annuncio del produttore, non prove eseguite dalla nostra redazione. L’azienda riferisce anche una valutazione cieca con Surge AI: annotatori professionisti hanno giudicato la qualità degli output di coding su una scala da uno a cinque, senza conoscere il modello. In quella valutazione ML4 Preview ottiene 3,74, dietro Claude Opus 5 a 4,22. Il confronto riguarda quel protocollo di valutazione; non stabilisce una superiorità generale su ogni attività di programmazione. [1]
Le tre percentuali non vanno raccolte in un grafico che le faccia sembrare risultati della stessa prova. Un valore più basso su un benchmark diverso può dipendere dal compito, e non dimostra che una capacità sia peggiore di un’altra. Per decidere se usare il modello in un repository, proponiamo invece un confronto controllato: stessi problemi, stesso stato iniziale del codice e stessi criteri di verifica. Gli esiti utili sono correzioni che superano i test, regressioni introdotte, modifiche non richieste e interventi umani necessari. I benchmark segnalano che vale la pena provare il modello; questi riscontri aiutano a capire se serve davvero nel proprio flusso.
DeepSWE 1.1: confronto pubblicato da Mistral nel comunicato di Large 4. Valutazioni dichiarate dal produttore, non test svolti da questa redazione; ogni grafico mantiene il proprio benchmark e le proprie condizioni. Fonte: MistralTerminal-Bench 4: confronto pubblicato da Mistral nel comunicato di Large 4. Valutazioni dichiarate dal produttore, non test svolti da questa redazione; ogni grafico mantiene il proprio benchmark e le proprie condizioni. Fonte: Mistral
Testo e immagini: dalla lettura alla prova delle risposte
Large 4 è descritto come un modello nativamente multimodale. Mistral presenta esempi di comprensione di documenti, grafici e immagini naturali, oltre a dimostrazioni su disegni tecnici, PDF e immagini geospaziali. L’annuncio parla anche di visual grounding: collegare una risposta agli elementi dell’immagine a cui si riferisce. La scheda tecnica elenca Structured Outputs, Function Calling e Document QnA tra le funzioni del prodotto. Queste voci indicano le capacità e le interfacce documentate; non costituiscono una garanzia che un agente sappia completare senza errori qualunque procedura che coinvolga documenti e strumenti. [1][2]
Un esempio illustrativo è l’analisi di una scheda tecnica con una tabella e un disegno. Si può chiedere al modello di estrarre un insieme limitato di campi, collegare ogni campo al punto del documento che lo sostiene e lasciare vuoti quelli che non trova. La verifica confronta gli output con risposte preparate in anticipo, includendo documenti con unità diverse, note a piè di pagina e informazioni mancanti. È più utile di una dimostrazione scelta perché produce una risposta impressionante: mette alla prova errori concreti, come scambiare un valore massimo con quello nominale o compilare un campo senza evidenza. Il risultato resta da controllare prima di usarlo in una decisione operativa.
Infrastruttura europea e condizioni ancora da verificare
Secondo l’annuncio, ML4 è stato addestrato da zero su 3.800 GPU NVIDIA Grace Blackwell nei datacenter europei di Mistral, e l’anteprima pubblica viene servita sulla stessa infrastruttura. L’azienda dichiara inoltre che una parte significativa dei dati di addestramento è multilingue, con oltre 160 lingue, comprese tutte quelle ufficiali dell’Unione europea. Sono elementi rilevanti del progetto, ma il supporto dichiarato alle lingue non equivale a una misura della qualità in italiano. Mistral annuncia anche una distribuzione futura in più regioni, con un deployment europeo gestito direttamente dall’azienda. [1]
Per un’organizzazione interessata al controllo dei dati, la collocazione dell’infrastruttura è soltanto una delle verifiche da fare. Prima di inviare materiale riservato, va letto ciò che il servizio effettivamente prevede per trattamento, conservazione e accesso ai dati, senza dedurlo dal nome del modello o dalla nazionalità del produttore. Anche i prezzi meritano un controllo sulla tariffa applicabile all’account e alla modalità utilizzata: riportare un costo senza distinguere condizioni e opzioni può rendere fuorviante una stima. In questo approfondimento non trasformiamo le promesse di distribuzione futura in condizioni contrattuali già verificate, né stimiamo il costo di un deployment dei pesi non ancora rilasciati.
Un esperimento utile prima di scegliere il modello
Un percorso illustrativo di adozione può partire da due piccoli insiemi separati: problemi di codice già risolti e documenti con risposte note. Per ciascun caso si conserva l’input, la richiesta, la risposta attesa e il criterio che decide se l’output è accettabile. Il confronto con la soluzione attuale deve usare lo stesso materiale e lo stesso livello di assistenza umana. Non basta contare le risposte corrette: vanno registrati anche il tempo di revisione, gli errori silenziosi e le informazioni che il modello dovrebbe ammettere di non conoscere. Questa procedura è una proposta di valutazione, non un test che la redazione afferma di avere già svolto su ML4.
La decisione finale dipende quindi dal problema, non dal soprannome o dalla dimensione del modello. Un team può continuare l’esperimento se le risposte diventano più utili senza aumentare gli errori difficili da rilevare; può fermarlo se il vantaggio scompare quando si includono i casi problematici. Chi richiede necessariamente i pesi dovrebbe tenere distinta questa decisione da quella sull’API: il rilascio annunciato aprirà una valutazione ulteriore, con materiali e condizioni da leggere allora. Il punto concreto di questo annuncio è una nuova anteprima da misurare, accompagnata da un prossimo rilascio promesso; entrambe le fasi richiedono criteri verificabili, non fiducia automatica nei risultati promozionali.
Dalla lettura all'azione
Da mettere in pratica
Distinguere l’API in public preview dal rilascio dei pesi annunciato per fine ottobre.
Conservare la versione della documentazione usata: annuncio e scheda divergono sui parametri attivi.
Confrontare il modello su casi con risposte note, mantenendo gli stessi input della soluzione attuale.
Verificare le risposte sui documenti con unità, note e campi mancanti, senza accettare dati inventati.
Registrare errori, regressioni e tempo di revisione, oltre alla qualità apparente della risposta.
Controllare condizioni del servizio e tariffa applicabile prima di inviare dati riservati o stimare i costi.
Il 7 ottobre 2026 GitHub ha reso generalmente disponibile il sandboxing locale per Copilot CLI, l'app Copilot e VS Code, permettendo l'esecuzione di workflow agentici in ambienti isolati e sicuri.
GitHub ha annunciato il 6 ottobre 2026 un aggiornamento per gli IDE volto a correggere un errore di attribuzione dei dati relativi agli agenti, che causava una sottostima delle linee di codice e dell'attività nei report di utilizzo.
Rilasciato il 6 ottobre 2026, Gemini Nano Banana 2.1 introduce miglioramenti nella qualità visiva, nel rendering del testo e nel supporto per formati panoramici, sostituendo il modello Nano Banana 2.


Parliamone
Hai un’esperienza da condividere o una domanda? Scrivi un commento pertinente, senza pubblicità o link.