GitHub presenta ReviewBench: come valutare un revisore del codice basato su AI
ReviewBench mette alla prova gli assistenti che revisionano il codice. Come funziona il benchmark di GitHub, quali numeri leggere e come usarli per scegliere con criterio.
Il 5 ottobre 2026 GitHub ha presentato ReviewBench, un benchmark per confrontare gli agenti AI che revisionano il codice. È disponibile in research preview: una versione di ricerca che permette di esplorare il dataset e valutare il proprio agente. La domanda a cui prova a rispondere è concreta: quando un assistente commenta una modifica al software, quanti problemi reali riesce a trovare? [1]
Per chi sviluppa software, scegliere un revisore automatico soltanto dal numero di commenti può portare fuori strada. Immaginiamo, come esempio, un assistente che scrive dodici osservazioni e un altro che ne scrive tre. Il primo potrebbe trovare più errori, oppure produrre più segnalazioni inutili. Per decidere serve un confronto sui problemi individuati, su quelli sfuggiti e sul tempo che i revisori spendono a leggere le segnalazioni. [1]
ReviewBench offre un terreno comune per questo confronto. La sua utilità pratica va cercata nella scelta di uno strumento e nella valutazione dei suoi aggiornamenti: un punteggio può orientare una prova, mentre la decisione di adottarlo richiede di osservare anche ciò che succede nel proprio progetto. [1]
Un dataset di 219 modifiche reali
GitHub ha analizzato la distribuzione di 103,9 milioni di pull request per costruire il corpus. Il benchmark contiene 219 pull request, provenienti da 187 repository pubblici e distribuite su 19 linguaggi. Le due quantità descrivono cose diverse: la prima serve a studiare il lavoro di revisione su GitHub, la seconda indica le modifiche effettivamente incluse nel test. [1]
Una pull request raccoglie modifiche al codice da discutere e revisionare prima di integrarle. Nel costruire il dataset, GitHub ha dato più peso alle modifiche di dimensione intermedia e a quelle più ampie, riducendo la presenza di piccoli cambiamenti su un solo file. Il corpus privilegia così anche casi sostanziali che coinvolgono più file. [1]
Per interpretare un risultato, un team può partire da qui: quali linguaggi utilizza e quanto sono grandi le sue modifiche abituali? Un buon risultato complessivo diventa più interessante quando riguarda anche il tipo di lavoro che quel team deve revisionare. Questa verifica può aiutare a scegliere quali casi approfondire nella prova locale. [1]
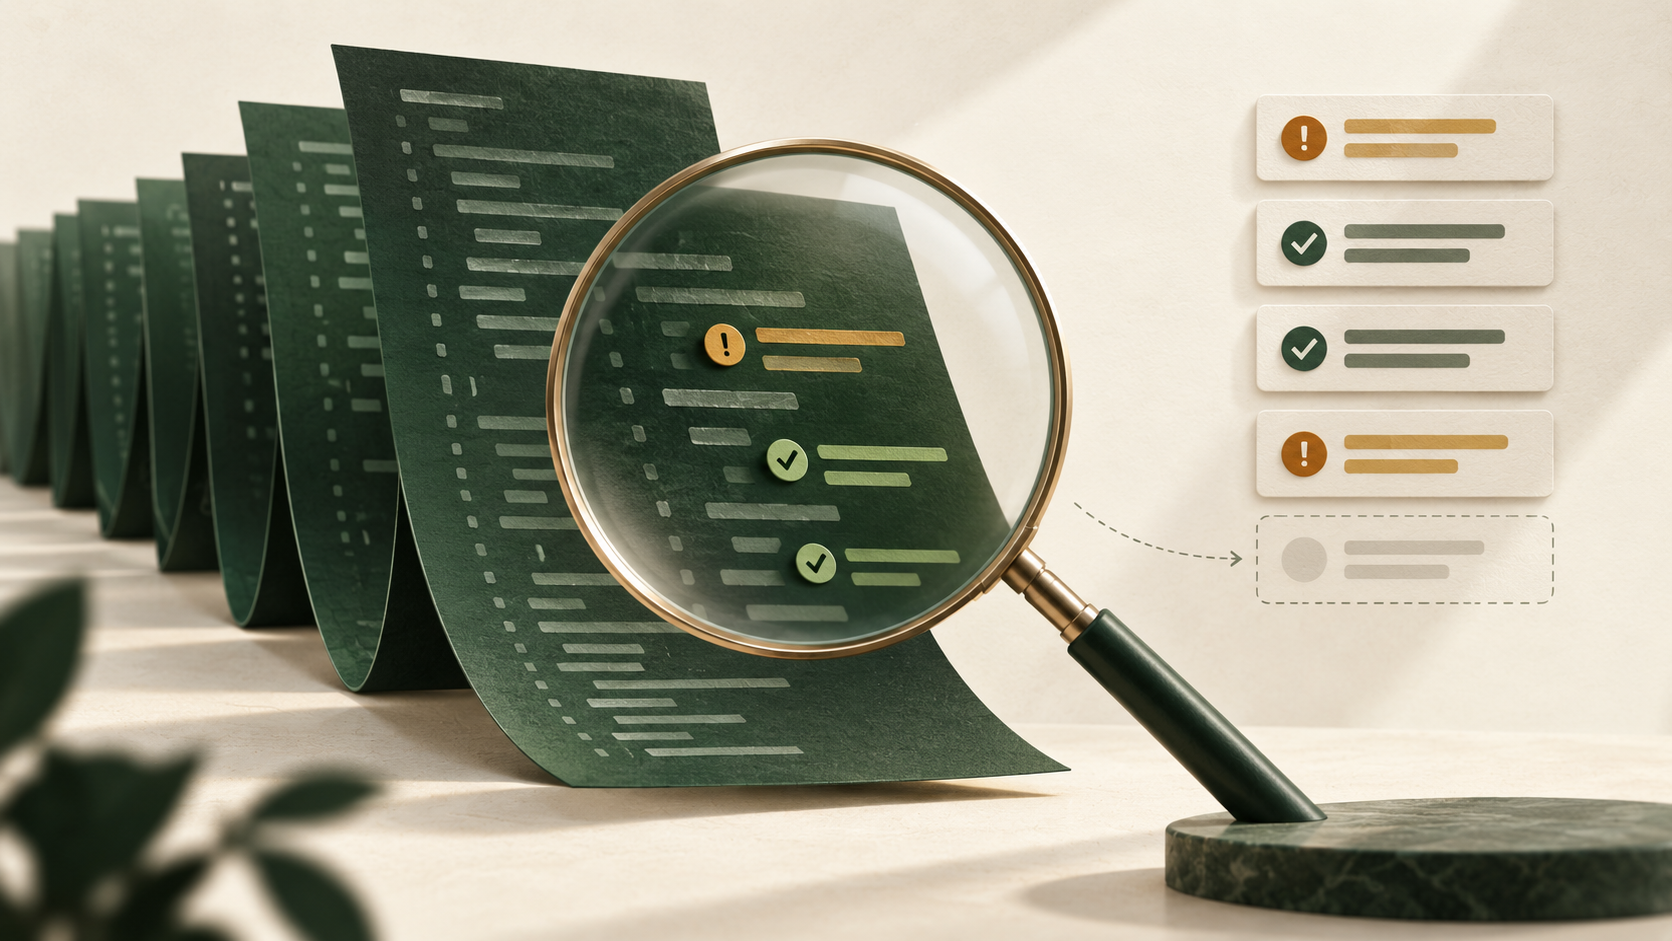
Infografica · ReviewBench: leggere oltre il punteggio. Fonti: [1]Leggi il contenuto dello schema
Tre domande per interpretare il risultato di una revisione.
Precisione · Le segnalazioni sono valide?: Misura la quota di segnalazioni valide tra quelle prodotte dal revisore.
Recall · Quanti problemi vengono trovati?: Misura la quota di problemi validi conosciuti che il revisore individua.
Riferimento · Quali problemi vengono contati?: Grounded usa problemi già etichettati. Augmented considera anche nuove segnalazioni: il riferimento può cambiare tra agenti.
Precisione e recall: due domande diverse
La precisione misura quale quota delle segnalazioni è valida. La recall misura quale quota dei problemi validi conosciuti viene individuata. ReviewBench distingue poi due famiglie di risultati: le metriche grounded usano il gruppo di problemi già etichettati nel dataset; quelle augmented valutano anche le nuove segnalazioni che non corrispondono a un problema già catalogato. [1]
La distinzione conta quando un agente trova qualcosa che i revisori del dataset non avevano previsto. Un riferimento fisso può essere incompleto; riconoscere una nuova segnalazione valida aiuta a capire le capacità del singolo sistema. Per confrontare agenti diversi, però, occorre sapere se il riferimento usato nei calcoli è rimasto uguale. [1]
GitHub indica la grounded recall come riferimento principale per il confronto fra sistemi. La augmented recall modifica il denominatore in base ai problemi scoperti da ciascun agente: per questo le metriche augmented sono presentate anche come diagnosi aggiuntiva del singolo sistema. Leggere soltanto un punteggio aggregato rischia di nascondere questa differenza. [1]
Cosa dimostra il benchmark, e quali domande restano
Prima del rilascio, ingegneri senior che non avevano costruito il dataset hanno riesaminato le etichette dei problemi. GitHub riporta un accordo del 96,6% con ReviewBench. È una misura della coerenza di quelle valutazioni sul dataset; non è il tasso di errori che qualsiasi agente riuscirà a trovare nel codice di un’azienda. [1]
Una prova utile può chiedere anche quante segnalazioni richiedono lavoro al team. Un assistente che trova un errore grave e aggiunge molti commenti marginali può offrire un compromesso diverso da uno più selettivo. Conviene quindi definire prima della prova quali errori contano maggiormente e quanto rumore si è disposti ad accettare. [1]
Il contesto del proprio software merita una verifica dedicata: convenzioni interne, componenti critici e modifiche ricorrenti possono richiedere criteri di revisione specifici. Una classifica offre un punto di partenza. Un campione di pull request del proprio progetto permette di esaminare se le segnalazioni aiutano davvero chi deve prendere la decisione finale. [1]
Il rapporto con GitHub Copilot code review
Copilot code review è il prodotto che fornisce commenti sulle pull request. La documentazione GitHub descrive le sue capacità agentiche basate su GitHub Actions e la possibilità di aggiungere istruzioni al repository. Il file .github/copilot-instructions.md può contenere indicazioni di revisione valide per tutto il progetto. [2]
Questo chiarisce due passaggi da valutare separatamente: confrontare un agente con un benchmark e osservarlo nel flusso di revisione del team. La documentazione di Copilot spiega il secondo passaggio e fa da contesto; l’annuncio di ReviewBench è la fonte per le caratteristiche del benchmark. Affiancare le due letture aiuta a preparare una prova con obiettivi chiari. [1][2]
Un esempio operativo è raccogliere le convenzioni che il revisore deve considerare, scegliere alcune modifiche già discusse dal team e verificare i commenti prodotti. Le istruzioni possono comunicare le convenzioni all’agente; il controllo dei risultati serve a capire se le sta applicando. Si può così distinguere un problema di configurazione da una capacità che lo strumento deve ancora dimostrare. [1][2]
Come impostare una prima valutazione
La procedura descritta da GitHub prevede l’accesso al sito ReviewBench, la registrazione dell’agente e la fornitura di un’immagine container, della configurazione e della propria chiave del modello. È previsto un insieme di prova di 25 pull request; la valutazione completa comprende 219 pull request. I punteggi restano privati finché un responsabile non riesamina e approva la richiesta di pubblicazione nella classifica. [1]
Prima di iniziare, un team può scegliere un obiettivo circoscritto: ridurre i commenti inutili, trovare più problemi di correttezza oppure migliorare l’individuazione di una categoria critica. Stabilire l’obiettivo rende più leggibili i risultati. Aiuta anche a evitare che una metrica in crescita venga interpretata come un miglioramento di tutto il processo. [1]
Per la prova locale si possono selezionare modifiche piccole, cambiamenti su più file e un caso che tocca un componente importante. I revisori possono annotare quali commenti sono utili, quali problemi erano già noti e quali segnalazioni richiedono verifiche ulteriori. Ripetere la stessa prova dopo un aggiornamento offre un criterio concreto per decidere se mantenere la configurazione. [1]
A chi può essere utile ReviewBench
Un benchmark di questo tipo può interessare chi sviluppa agenti di revisione e chi deve scegliere uno strumento per un gruppo di lavoro. Nel primo caso aiuta a impostare confronti ripetibili; nel secondo offre domande migliori da portare alla prova sul proprio codice. Anche un team piccolo può usarlo come occasione per chiarire che cosa si aspetta dalla revisione automatica. [1]
Il criterio operativo è semplice: cercare segnalazioni utili, comprendere quelle mancanti e misurare il lavoro richiesto per verificarle. Il valore di ReviewBench sta nell’offrire un riferimento comune e risultati da esaminare. Il valore per il proprio progetto emerge quando quei risultati vengono messi alla prova con modifiche, priorità e revisori reali. [1]
Dal benchmark alla scelta del revisore
Un esempio illustrativo: due revisori producono risultati diversi sullo stesso insieme di modifiche. Prima di scegliere, un team potrebbe classificare i commenti come validi, inutili o ancora da discutere, conservando anche i problemi che nessun revisore ha individuato. Il confronto dovrebbe usare gli stessi casi e chiarire quale riferimento viene adottato. Un elenco di commenti molto lungo non equivale a una revisione più utile, così come poche segnalazioni non dimostrano che il codice sia privo di problemi. [1]
Per collegare il risultato del benchmark al lavoro quotidiano, il team potrebbe affiancare una raccolta di casi propri: modifiche comprensibili, problemi conosciuti e criteri espliciti per valutare le segnalazioni. Andrebbero annotati anche i disaccordi fra revisori umani, invece di trattare ogni giudizio come definitivo. La scelta finale può allora considerare qualità dei commenti, problemi trascurati e lavoro di verifica richiesto. Questa proposta non sostituisce il benchmark pubblico: serve a capire se un risultato generale si traduce in un aiuto concreto nel proprio contesto. [1]
Dalla lettura all'azione
Da mettere in pratica
Definisci quali categorie di errori vuoi trovare e quanto rumore può gestire il team.
Distingui il dataset di 219 pull request dall’analisi preliminare di 103,9 milioni di pull request.
Per confrontare agenti diversi, controlla la grounded recall e le metriche usate nel confronto.
Leggi le metriche augmented come informazioni aggiuntive sul singolo sistema.
Prepara un campione di modifiche del tuo progetto e annota utilità e limiti delle segnalazioni.
Conserva configurazione e risultati per ripetere la prova dopo un aggiornamento.
Il 7 ottobre 2026 GitHub ha reso generalmente disponibile il sandboxing locale per Copilot CLI, l'app Copilot e VS Code, permettendo l'esecuzione di workflow agentici in ambienti isolati e sicuri.
GitHub ha annunciato il 6 ottobre 2026 un aggiornamento per gli IDE volto a correggere un errore di attribuzione dei dati relativi agli agenti, che causava una sottostima delle linee di codice e dell'attività nei report di utilizzo.
Rilasciato il 6 ottobre 2026, Gemini Nano Banana 2.1 introduce miglioramenti nella qualità visiva, nel rendering del testo e nel supporto per formati panoramici, sostituendo il modello Nano Banana 2.

Parliamone
Hai un’esperienza da condividere o una domanda? Scrivi un commento pertinente, senza pubblicità o link.